AI 모델 디자인 비교: 웹 UI 시안과 브랜드 작업에 맞는 선택 기준
웹 UI 생성을 위한 AI 모델 디자인 비교에서 DesignArena 순위를 읽는 법과 한국어 화면·브랜드 적용·반복 수정 결과를 비교하는 절차를 정리합니다. 모델 순위와 실제 제품의 편집 기능을 구분해 작업 조건에 맞는 후보를 고르는 기준을 제시합니다.
Hyuk · · 4분 · AI
핵심 요약
- Muse Wonder (max)는 2026년 10월 31일 DesignArena Website 종합 순위 1위로, 신규 웹 UI 시안의 우선 비교 후보로 삼을 만합니다.
- 선호도 순위로 후보를 좁힌 뒤 같은 한국어 콘텐츠로 자유 생성, 브랜드 적용, 모바일 수정 결과를 비교하세요.
- 모델 순위와 제품의 편집 기능은 별도로 판단하고, 실제 앱에서 선택할 수 있는 모델과 설정을 확인해야 합니다.
신규 웹 UI 시안을 뽑는 용도라면 Muse Wonder (max)를 첫 후보로 올려 둘 만합니다. 2026년 10월 31일 기준 DesignArena의 Website 종합 순위에서 1위를 기록했거든요. 반대로 이미 운영 중인 서비스에 붙일 화면이라면 순위보다 먼저 확인할 게 있습니다. 브랜드 규칙을 지키는지, 몇 번 고친 뒤에도 꼭 필요한 요소가 남아 있는지부터 보세요.
두 작업은 평가 기준이 꽤 다릅니다. 자유 시안에서는 화면 구성과 첫인상이 결과를 좌우하지만, 브랜드 작업에서는 정해진 색상·서체·컴포넌트를 얼마나 충실히 따르느냐가 훨씬 무거워져요. 그래서 저는 순위로 후보를 좁히고, 마지막 선택은 실제 작업 조건에 맞춰 하라고 권합니다. 여기서 다루는 범위는 웹 UI 생성까지입니다. 포스터나 일러스트는 평가 대상이 달라 따로 봐야 해요.
순위표의 점수는 무엇을 말해 주나
기준일의 Website 종합 순위에서 주요 후보만 추렸습니다. 순위는 네 모델끼리 매긴 순서가 아니라 전체 순위이고, 점수와 대결 수도 종합 표에 나온 값 그대로예요.
| 전체 순위 | 모델·설정 | Elo | 대결 수 |
|---|---|---|---|
| 1 | Muse Wonder (max) | 1370 | 5,659 |
| 4 | GPT-6 Astra (max) | 1337 | 2,734 |
| 7 | Claude Opus 5.5 | 1325 | 3,779 |
| 10 | Gemini 4 Argon | 1315 | 10,428 |
DesignArena는 같은 요청으로 만든 결과물 두 개를 익명으로 보여 주고, 사용자가 고른 쪽을 집계합니다. 공식 방법론에 따르면 여기에 Bradley–Terry 통계 모형을 적용해 상대적인 선호도를 추정해요. 결국 이 점수는 그 평가 환경에서 어느 결과가 더 많이 선택됐는지를 보여 주는 지표로 읽는 게 맞습니다.
흔히 헷갈리는 지점이 두 군데 있습니다. 하나는 점수 차이예요. 차이가 근소하면 그것만으로 우열을 확실히 가르기 어렵습니다. 다른 하나는 대결 수인데, 이건 비교가 집계된 횟수일 뿐 품질 점수가 아니에요. 실행 조건도 결과에 영향을 줄 수 있으니 GPT-6 Astra (max)처럼 모델명과 설정을 꼭 함께 적어 두세요. 그래야 무엇과 무엇을 비교했는지가 분명해집니다.
같은 한국어 페이지로 직접 비교해 보기
순위는 출발점일 뿐이라, 실제 작업에 맞는지는 같은 조건으로 돌려 봐야 알 수 있어요. 한국어 서비스 소개 페이지 하나를 정해 자유 생성 결과와 브랜드 규칙을 적용한 결과를 나란히 놓고 보세요. 긴 한국어 제목, 설명 문단, 요금 안내를 모델마다 똑같이 넣어 줘야 콘텐츠 차이 때문에 판단이 흔들리지 않습니다.
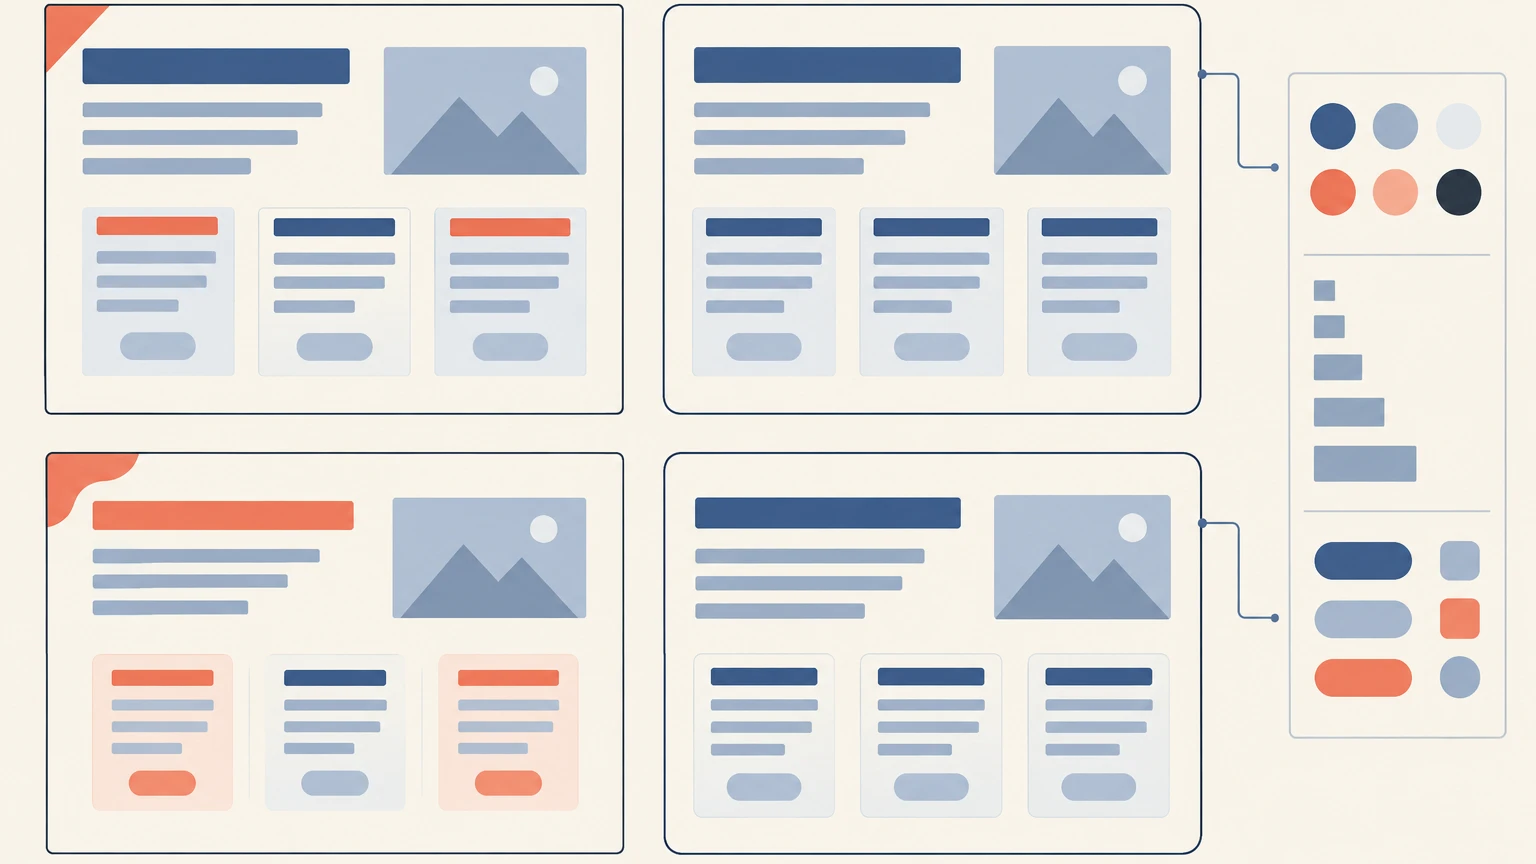
- 같은 콘텐츠와 요청으로 페이지를 자유롭게 생성합니다.
- 동일한 브랜드 색상·서체·컴포넌트를 제공해 화면에 적용하도록 요청합니다.
- 같은 모바일 수정 지시를 전달하고, 수정 전후에 유지된 요소와 달라진 요소를 비교합니다.
- 생성과 수정을 반복하면서 모델·설정·요청 조건을 함께 기록합니다.
첫 화면을 볼 때는 장식에 눈이 먼저 가기 쉬운데, 제목과 본문의 위계를 우선 보시길 권합니다. 제목과 설명 문단이 확실히 구분되는지, 구역 사이 여백이 일관적인지, 긴 한국어 문장이 읽기 편한 위치에서 줄바꿈되는지가 핵심이에요. 색상이 강조와 구분에 어떤 역할을 맡고 있는지도 같이 적어 두면 좋습니다. 이렇게 기록해 두면 "세련됐다"는 막연한 인상을 구체적인 말로 풀어낼 수 있거든요.
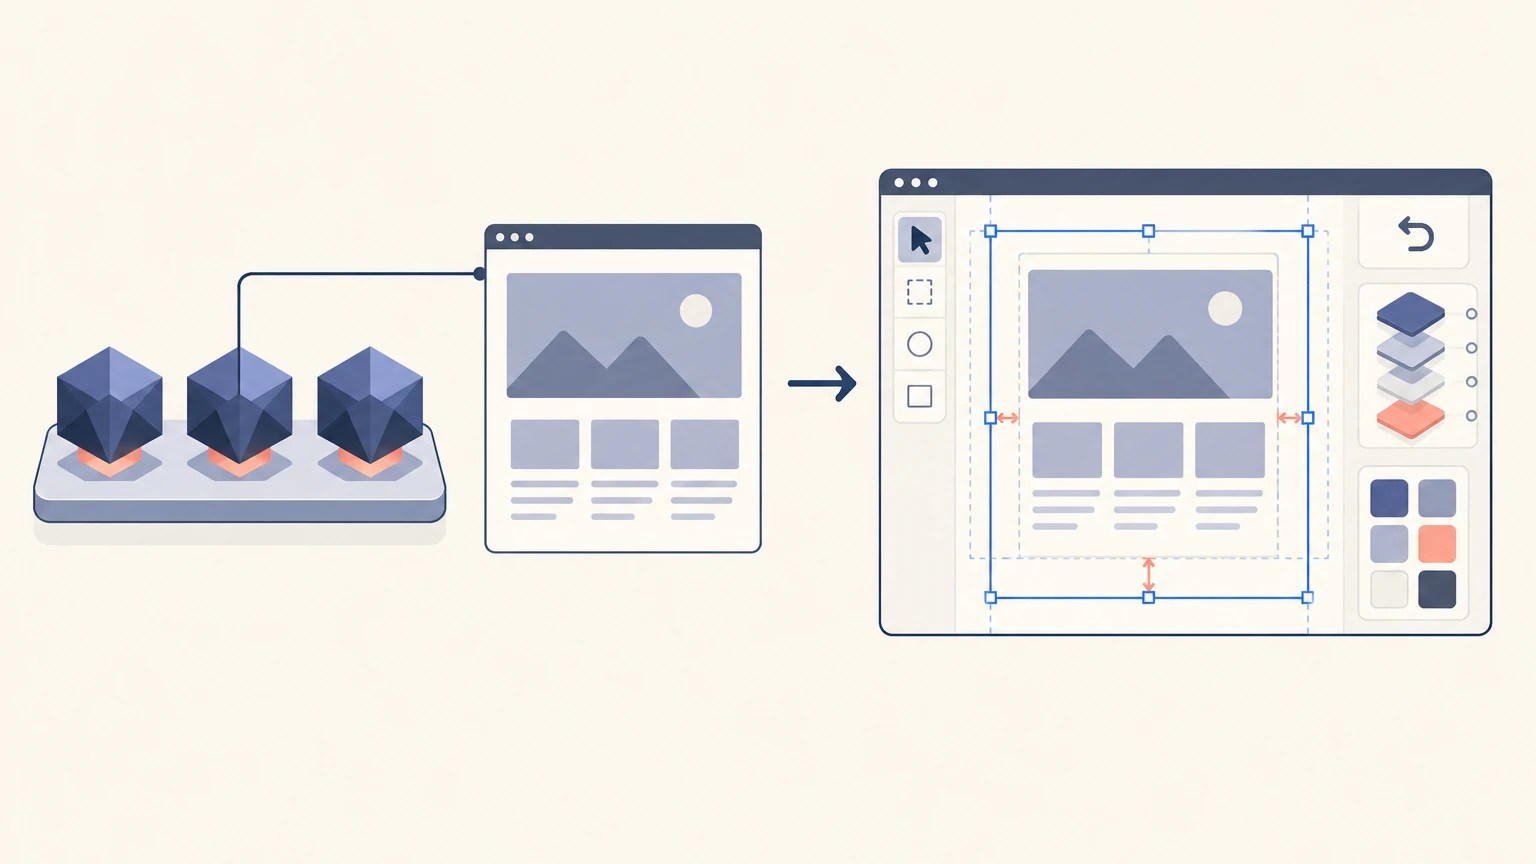
브랜드를 적용한 뒤에는 지정한 요소가 그대로 남았는지, 화면 전체의 균형은 괜찮은지를 함께 봅니다. 그다음 "색상과 콘텐츠는 유지하고 모바일에서만 정보 순서를 바꿔 주세요"라는 같은 지시를 모든 모델에 보내 보세요. 모바일 순서가 바뀌었는지만 보면 반쪽짜리 확인입니다. 기존 컴포넌트나 데스크톱 구성이 쓸데없이 바뀌지 않았는지까지 봐야 해요.
첫 화면과 수정 후 화면을 함께 놓고 봐야 선택의 근거가 또렷해집니다.
모델 이름과 제품 기능은 따로 봐야 하는 이유
모델 순위와 제품의 편집 기능은 별개로 판단하셔야 합니다. 예를 들어 Claude Opus는 모델 계열명이고, Claude Design은 디자인 작업용 제품 이름이에요. 순위표에 적힌 모델 이름만 봐서는 실제 앱에서 어떤 수정 기능을 쓸 수 있는지까지 알기 어렵습니다.
Claude Design의 디자인 시스템 적용 안내를 보면 GitHub 저장소, 디자인 파일, 업로드 자료에서 디자인 시스템을 가져와 생성 결과를 검사하고 수정하는 기능이 소개돼 있어요. 기존 브랜드를 다루는 작업이라면 이런 기능이 내 작업 흐름에 맞는지 살펴볼 가치가 있습니다. 다만 기능이 제공된다는 사실과, 그래서 다른 모델보다 브랜드 일관성이 뛰어나다는 평가는 서로 다른 이야기예요.
결정하기 전에는 앱에서 실제로 고를 수 있는 모델과 설정, 지금 제공되는 편집 기능을 직접 확인하세요. 한국어 생성과 브랜드 적용을 같은 조건에서 비교한 결과가 아직 없는 만큼, 한국어 화면과 브랜드 작업에서 모델별 우열은 확인되지 않은 상태입니다.
자주 묻는 질문
- DesignArena에서 대결 수가 많으면 디자인 품질도 더 높은가요?
- 대결 수는 비교가 집계된 횟수이며 품질 점수는 아닙니다. 점수는 해당 평가 환경의 상대적인 선호도를 나타내며, 근소한 차이만으로 확실한 우열을 판단하기는 어렵습니다.
- 한국어 웹 UI와 브랜드 작업에 가장 좋은 모델은 무엇인가요?
- 제시된 순위와 비교 근거만으로는 모델별 우열이 확인되지 않았습니다. 같은 한국어 콘텐츠와 브랜드 규칙을 제공하고, 반복 수정 후 필요한 요소가 유지되는지 비교하는 편이 좋습니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.