Apple Silicon 로컬 LLM 벤치마크, Uzu 수치와 측정 조건 읽는 법
Apple Silicon 로컬 LLM 벤치마크에서 공개된 Uzu의 약 2.96배 출력 속도 차이를 실행 구성과 측정 범위에 따라 해석합니다. 입력·출력 속도의 차이와 내 Mac에서 재측정할 조건을 정리했습니다.
Hyuk · · 4분 · AI
핵심 요약
- Uzu의 약 2.96배 출력 속도는 개발사가 M5 Max 128GB의 특정 실행 구성에서 공개한 결과입니다.
- 출력 tok/s만으로 첫 토큰 대기 시간이 같은 비율로 줄어든다고 계산할 수는 없습니다.
- 재측정할 때는 모델·양자화·투기적 디코딩 설정과 입력·출력 길이, 온도 조건을 맞춰야 합니다.
- M5의 가속 배율을 다른 Mac에 적용하기 전에 해당 칩의 측정 결과를 확인하는 편이 타당합니다.
Uzu 개발사가 공개한 값으로는 출력 속도가 142 tok/s, llama.cpp가 48 tok/s입니다. 약 2.96배 차이예요. 2026년 10월 20일 M5 Max 128GB에서 Qwen 3.6 27B를 실행한 결과입니다. Apple Silicon 로컬 LLM 벤치마크를 읽을 때 배율보다 먼저 확인할 것은 이 숫자가 어떤 실행 구성에서 나왔느냐예요.
측정 장비는 CPU 18코어·GPU 40코어이고, 운영체제는 macOS 27.0으로 표기돼 있습니다. Uzu는 추론 엔진이며, 비교에 쓰인 Uzu 모델은 Mirai-M이에요. 공식 제품 페이지의 출력 그래프에는 투기적 디코딩 관련 표기도 함께 나옵니다.
그래서 엔진 이름보다 실행 구성을 먼저 봐야 합니다. 투기적 디코딩은 작은 초안 모델이 후보 토큰을 제안하고, 이를 검증하는 방식입니다. 초안 모델과 양자화, 검증 방식까지 달라졌다면 지금 보이는 차이가 엔진을 바꾼 효과인지 구성 전체를 최적화한 효과인지 나눠서 판단해야 해요.
출력 속도가 빠르면 첫 토큰도 빨리 나올까
tok/s는 초당 처리하는 토큰 수를 뜻합니다. 아래 표의 버전과 메모리 단위는 제품 페이지 표기를 그대로 따랐어요.
| 엔진·버전 | 출력 속도 | 입력 처리 속도 | 상주 메모리 |
|---|---|---|---|
| Uzu 0.6.9 | 142 tok/s | 1,665 tok/s | 15.63 GB |
| llama.cpp 0.7.0 | 48 tok/s | 716 tok/s | 17.36 GB |
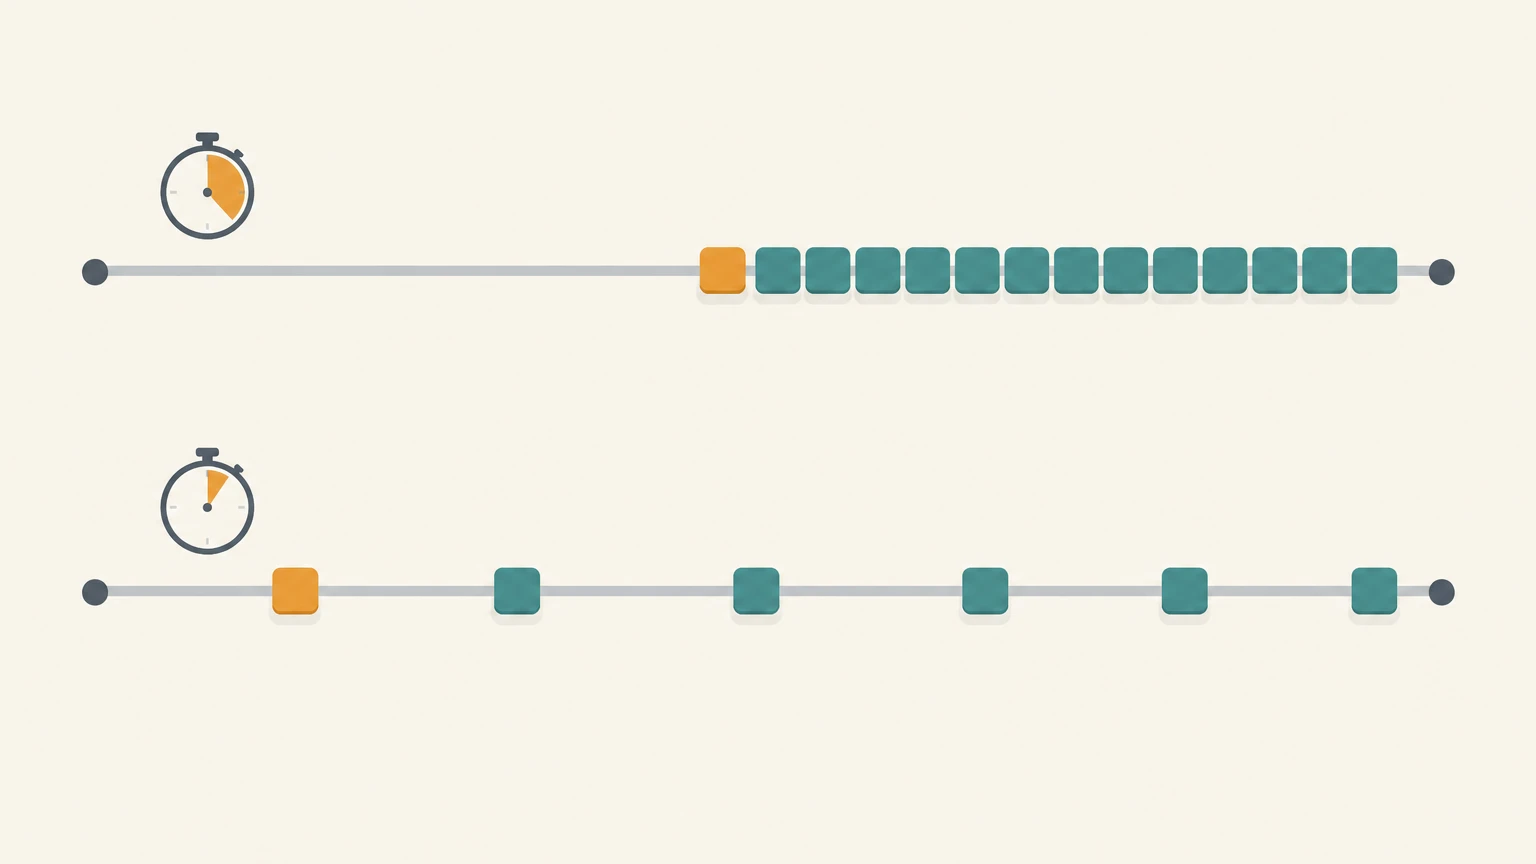
출력 속도는 답변이 생성되는 구간을 재는 지표입니다. 요청을 보낸 뒤 첫 토큰이 나오기까지는 입력 처리 같은 앞 단계도 영향을 줍니다. 그러니 출력 tok/s가 높다고 첫 토큰 대기 시간까지 같은 비율로 줄어든다고 계산하면 안 되는데, 표를 볼 때 흔히 헷갈리는 지점이 바로 여기예요.
입력 속도는 측정 범위부터 확인하세요.
공식 Metrics를 보면 Uzu는 자체 prefill_tokens_per_second 지표를 쓰고, MLX는 ‘입력 토큰 수÷첫 토큰까지 걸린 시간’으로 계산합니다. 앞의 것은 입력을 미리 처리하는 단계를 기준으로 삼고, 뒤의 것은 첫 토큰이 나올 때까지의 시간을 기준으로 삼아요. 같은 입력 tok/s 열에 나란히 있더라도 측정 범위가 같다고 전제하면 비교를 잘못 읽게 됩니다.
내 Mac에서 다시 잴 때 무엇을 고정할까
옵션을 만지기 전에 조건부터 기록해 두길 권합니다. 무엇을 고정했고 무엇을 바꿨는지 남아 있어야 속도 차이의 원인을 좁혀 갈 수 있거든요.
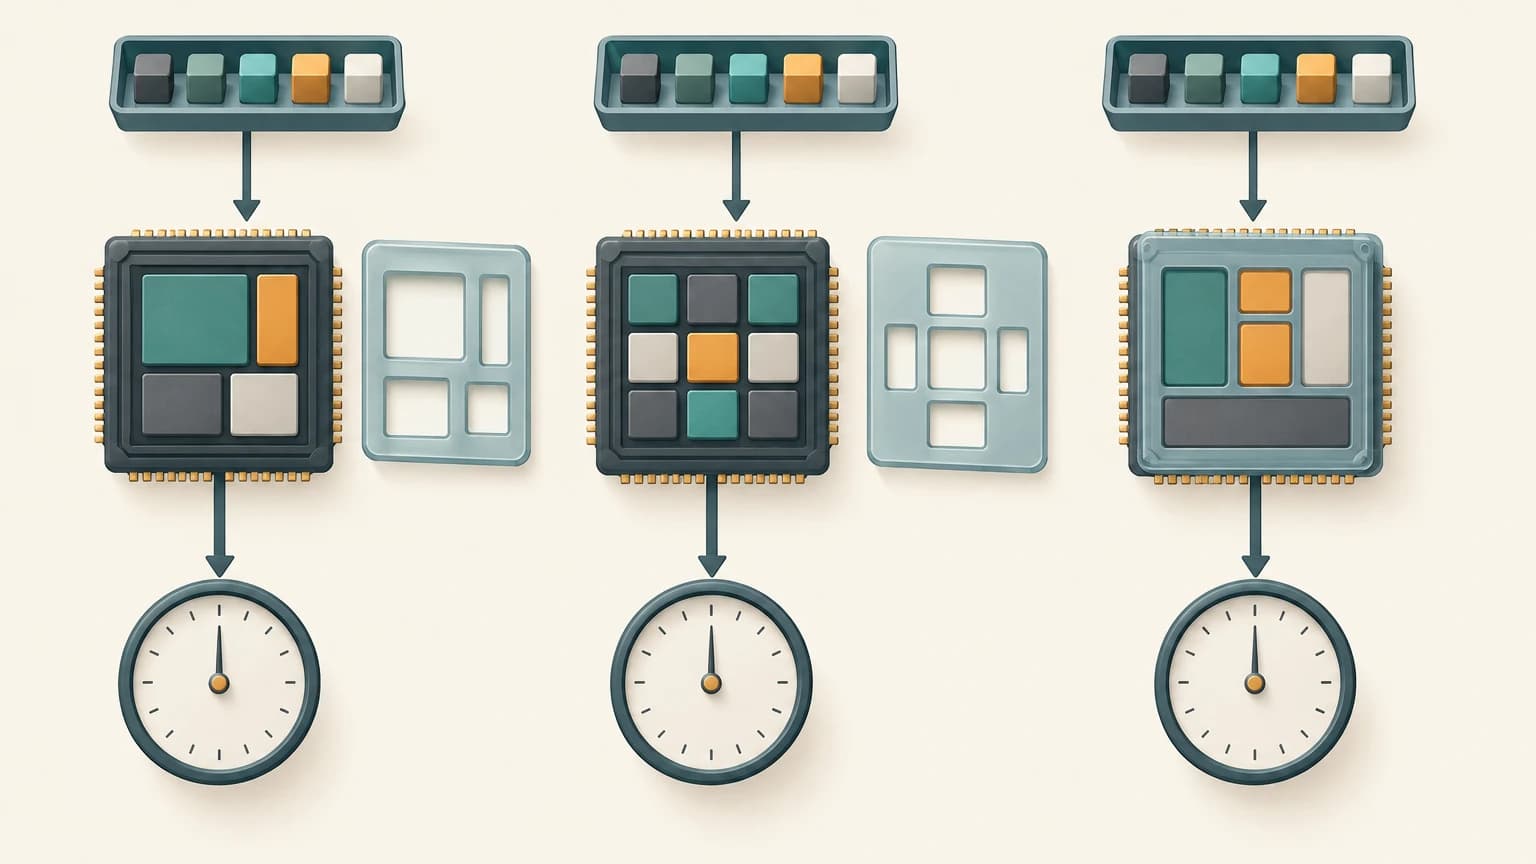
- 칩·메모리·운영체제와 엔진 버전을 기록합니다.
- 모델 파일·양자화와 투기적 디코딩 설정을 고정합니다.
- 입력 토큰 수·기존 문맥 길이·실제 출력 길이를 맞춥니다.
- 워밍업 여부와 온도 조건을 맞추고 반복 측정해 평균과 편차를 함께 봅니다.
Metrics에 적힌 조건은 약 1,357개 입력 토큰, 최대 4,096개 출력 토큰, 설정별 3회 실행입니다. 매 실행 전에는 CPU와 GPU 온도가 모두 60°C 미만이 될 때까지 기다리고, 지원 범위 안에서 샘플링 설정을 맞추도록 명시돼 있어요. 최대 출력 길이는 어디까지나 상한이라서 실제로 생성된 토큰 수는 따로 기록해 둬야 합니다.
도구가 어디까지를 재는지도 결과 옆에 적어 두는 편이 좋아요. llama-bench 문서는 입력 처리 pp, 출력 생성 tg, 결합 측정 pg를 구분하고 평균과 표준편차를 함께 보여 줍니다. 다만 토큰화와 샘플링 시간은 측정에서 빠집니다. 이 값을 앱의 전체 응답 시간에 그대로 맞대면 차이가 생겨요.
M5가 아닌 Mac에도 그대로 적용될까
Mirai는 초안 모델·양자화·GPU 커널을 M5에 맞춰 함께 설계했고 GPU Neural Accelerators를 활용한다고 설명합니다. 그렇다면 M5에서 나온 가속 배율을 M1·M2에 옮겨 적용하기보다, 해당 칩에서 측정한 결과부터 찾아보는 쪽이 타당해요.
양자화는 비트 수만 볼 게 아니라 품질 기준도 같이 봐야 합니다. Metrics는 Mirai-M·L을 각각 4비트·8비트 기준으로 삼되, llama.cpp 쪽은 출력 확률 분포의 차이를 나타내는 KL divergence가 가까운 체크포인트를 고른다고 설명해요. 이 기준을 맞췄다고 해서 한국어 답변이나 코드 생성 품질까지 같아지는 건 아닙니다. 실제로 쓸 작업의 품질은 따로 확인하는 게 맞아요.
문서끼리도 측정 조건이 조금씩 다릅니다. 9월 발표에서는 입력 길이가 1,355토큰이고 Metrics에서는 약 1,357토큰이에요. Metrics 안에서도 여러 평가 데이터셋을 섞는다는 설명과 동일 프롬프트를 반복한다는 설명이 함께 나옵니다. 어느 출력 지표에 어떤 절차가 적용됐는지는 공식 문서에서 확인해야 합니다.
결과를 인용할 때는 벤치마크에 쓰인 Uzu 0.6.9를 설치 예제의 버전으로 바꿔 적지 말고, 제품 페이지의 GB와 Metrics의 GiB도 구분해서 그대로 남겨 두세요. 이 수치를 내 Mac을 고르는 근거로 삼으려면, 같은 조건에서 독립적으로 재현한 결과와 함께 읽는 편이 좋습니다.
자주 묻는 질문
- Uzu는 LLM 모델인가요?
- Uzu는 추론 엔진이며, 이 비교에 사용된 Uzu 모델은 Mirai-M입니다.
- Uzu와 MLX의 입력 tok/s를 그대로 비교해도 되나요?
- 측정 범위를 먼저 확인해야 합니다. Uzu는 입력을 미리 처리하는 단계의 자체 지표를 쓰지만, MLX는 입력 토큰 수를 첫 토큰까지 걸린 시간으로 나눕니다.
- llama-bench 결과에 토큰화와 샘플링 시간도 포함되나요?
- llama-bench는 토큰화와 샘플링 시간을 제외합니다. 따라서 측정값을 앱의 전체 응답 시간에 곧바로 대응시키면 차이가 생깁니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.