Harness²의 에이전트 자기개선: 무엇을 바꾸고 다음 작업에 남길까
Harness² 에이전트 자기개선은 모델 가중치를 고정한 채 실행 하네스를 수정하고 개선 경험을 다음 작업에 활용합니다. 벤치마크 성과를 읽는 기준과 경험 전달 구조, 재현 시 확인할 편집 모델·전체 실행 비용을 짚습니다.
Hyuk · · 4분 · AI
핵심 요약
- Harness²는 모델 가중치 대신 프롬프트·도구 사용 지침·메모리 같은 실행 구성을 개선합니다.
- 다음 작업은 공통 기본 하네스에서 시작하며, 저장된 개선 경험은 새 수정안을 만드는 데 활용됩니다.
- 벤치마크의 최대 상승 폭은 실행 모델과 평가 지표가 서로 다른 구성에서 얻은 결과입니다.
- 개선 효과를 평가하려면 편집 모델 등 비교 조건을 고정하고 전체 호출 비용과 소요 시간을 함께 기록해야 합니다.
Harness² 에이전트 자기개선은 모델 가중치는 그대로 두고 프롬프트, 도구 사용 지침, 메모리 같은 실행 구성을 고친 뒤, 그 과정에서 얻은 경험을 다음 작업의 수정안을 만들 때 참고하는 방식입니다. 여기서 하네스는 모델이 도구를 쓰며 일할 수 있게 받쳐 주는 주변 시스템을 말해요. 모델을 다시 학습시키지 않고 모델이 일하는 조건을 손보는 쪽이라고 보면 됩니다.
처음 읽을 때는 두 가지를 떼어 놓고 보시길 권합니다. 하나는 지금 작업에서 바꾸는 설정이고, 다른 하나는 다음 작업에 남기는 경험이에요. 설정은 현재 실행을 낫게 만드는 데 쓰이고, 경험은 이후 수정안을 제안할 때 참고 자료가 됩니다. 이 둘을 섞으면 이전 작업의 설정을 그대로 물려받는 구조로 오해하기 쉬워서, 이 구분부터 잡아 두는 게 좋아요.
벤치마크 수치는 모델과 지표부터 보세요
논문 v1은 단일 개선 단계인 k=1에서 가장 크게 오른 사례를 아래처럼 보고합니다. 세 경우 모두 OpenCode 하네스를 썼지만 실행 모델과 평가 지표는 제각각이에요.
| 벤치마크·지표 | 실행 모델 | 기본 → 개선 | 상승 폭 |
|---|---|---|---|
| WorkBuddy-Bench·세 영역 평균 | GLM-5 | 64.2 → 75.7 | 11.5점 |
| JobBench·점수 | Gemini 3.5 Flash | 31.5 → 36.0 | 4.5점 |
| LAB·평가 기준별 통과율 | GLM-5 | 59.6% → 71.4% | 11.8%p |
표를 볼 때는 상승 폭보다 왼쪽 두 열을 먼저 확인하는 편이 좋습니다. 이 숫자들은 서로 다른 구성에서 나온 최대 상승 폭이라, 한 모델이 공통으로 달성한 개선율처럼 읽으면 곤란하거든요. LAB의 11.8%p도 점수가 아니라 통과율의 차이입니다. 수치는 작업 순서를 섞어 3회 실행한 평균이고, 표준편차는 논문 표 1–2에서 함께 볼 수 있어요.
제안하고, 시험하고, 조합한 뒤 경험을 남깁니다
작업 안에서의 개선은 Propose–Probe–Compose 순서를 따릅니다. 먼저 기준 실행을 관찰하고, 범용적인 실행 문제를 겨냥한 후보와 해당 도메인 문제를 겨냥한 후보를 각각 제안해요. 그다음 같은 작업에 후보 하네스를 적용해 시험하고, 실행 증거를 토대로 수정안을 조합하죠. 조합된 하네스로 최종 실행을 돌리면 한 작업이 마무리됩니다.
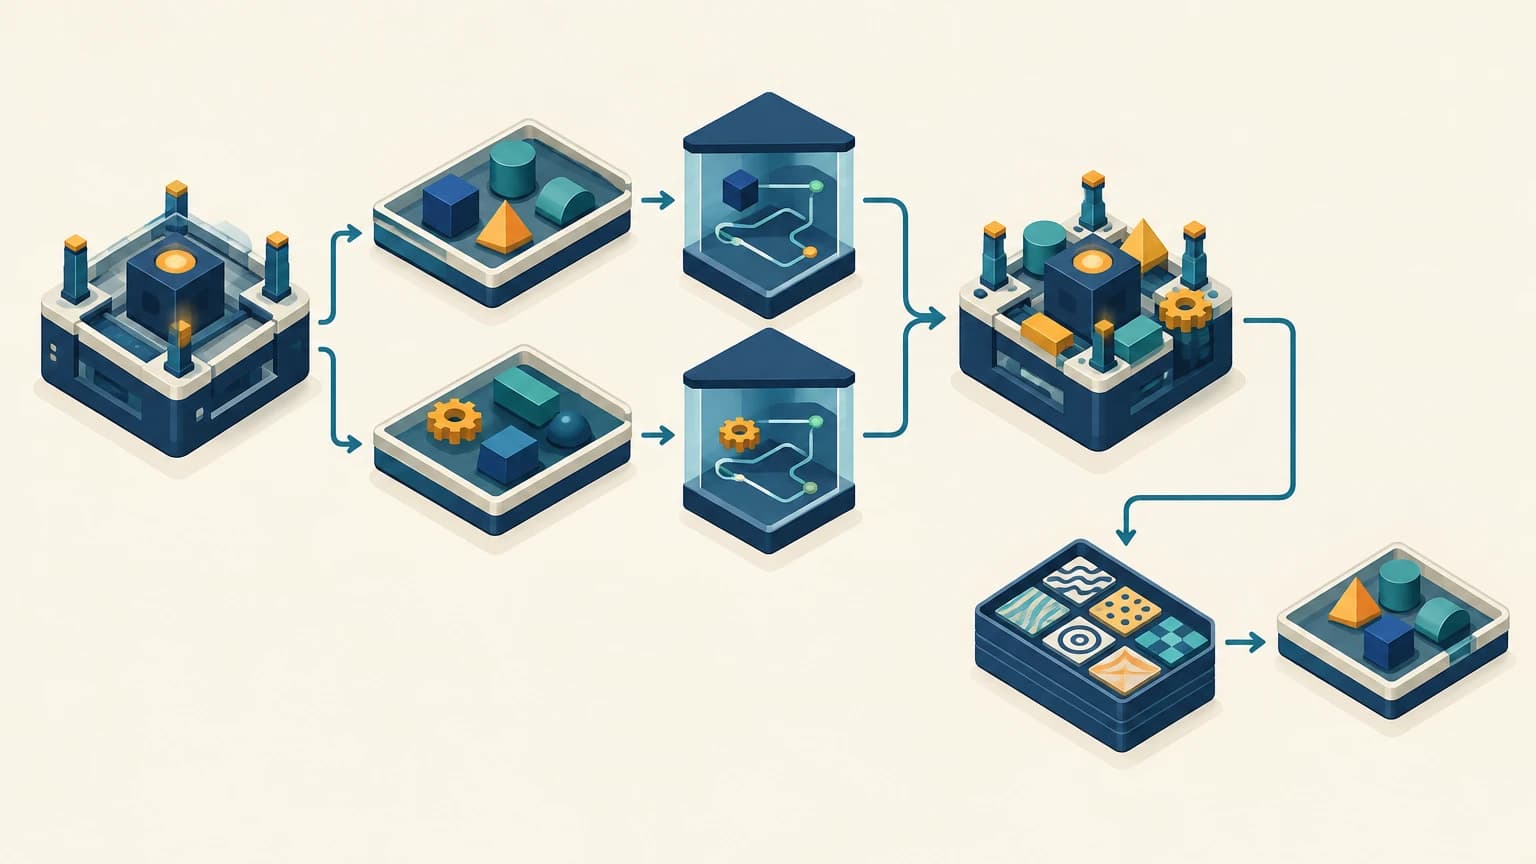
수정 근거는 후보마다 달라지는 실행 경로와 산출물의 차이예요.
그렇다고 이 비교를 정답을 확인하는 절차로 받아들이기는 어렵습니다. 실행 결과에 우연히 생긴 차이나 모델들이 함께 지닌 편향이 판단에 끼어들 수 있으니까요.
다음 작업으로 넘어가는 순간부터 설정과 경험은 서로 다른 길로 갑니다. 공식 프로젝트 설명을 보면 채택된 하네스와 EXPERIENCE.md는 개선 라이브러리에 저장돼요. 다음 작업의 실행기는 공통 기본 하네스에서 새로 출발하고, 라이브러리는 새 수정안을 만드는 데 쓰입니다. 앞에서 채택한 설정 전체가 다음 실행에 자동으로 붙는 구조가 아니라는 뜻이죠. 그래서 이 부분은 무엇을 저장하는지와 함께 어느 단계에서 그걸 읽는지까지 따져 봐야 정확히 이해할 수 있습니다.
검증한다면 점수와 전체 실행 비용을 같이 보세요
시작은 공개 저장소의 로컬 데모가 무난합니다. 모델 인증 없이 결정론적 편집기와 실제 Python 실행으로 흐름을 따라가 볼 수 있어서 구조를 파악하기에 부담이 적어요. 그 뒤에 소규모 모델 실험으로 넘어가면 구조 이해와 성능 평가를 따로 떼어 진행할 수 있습니다.
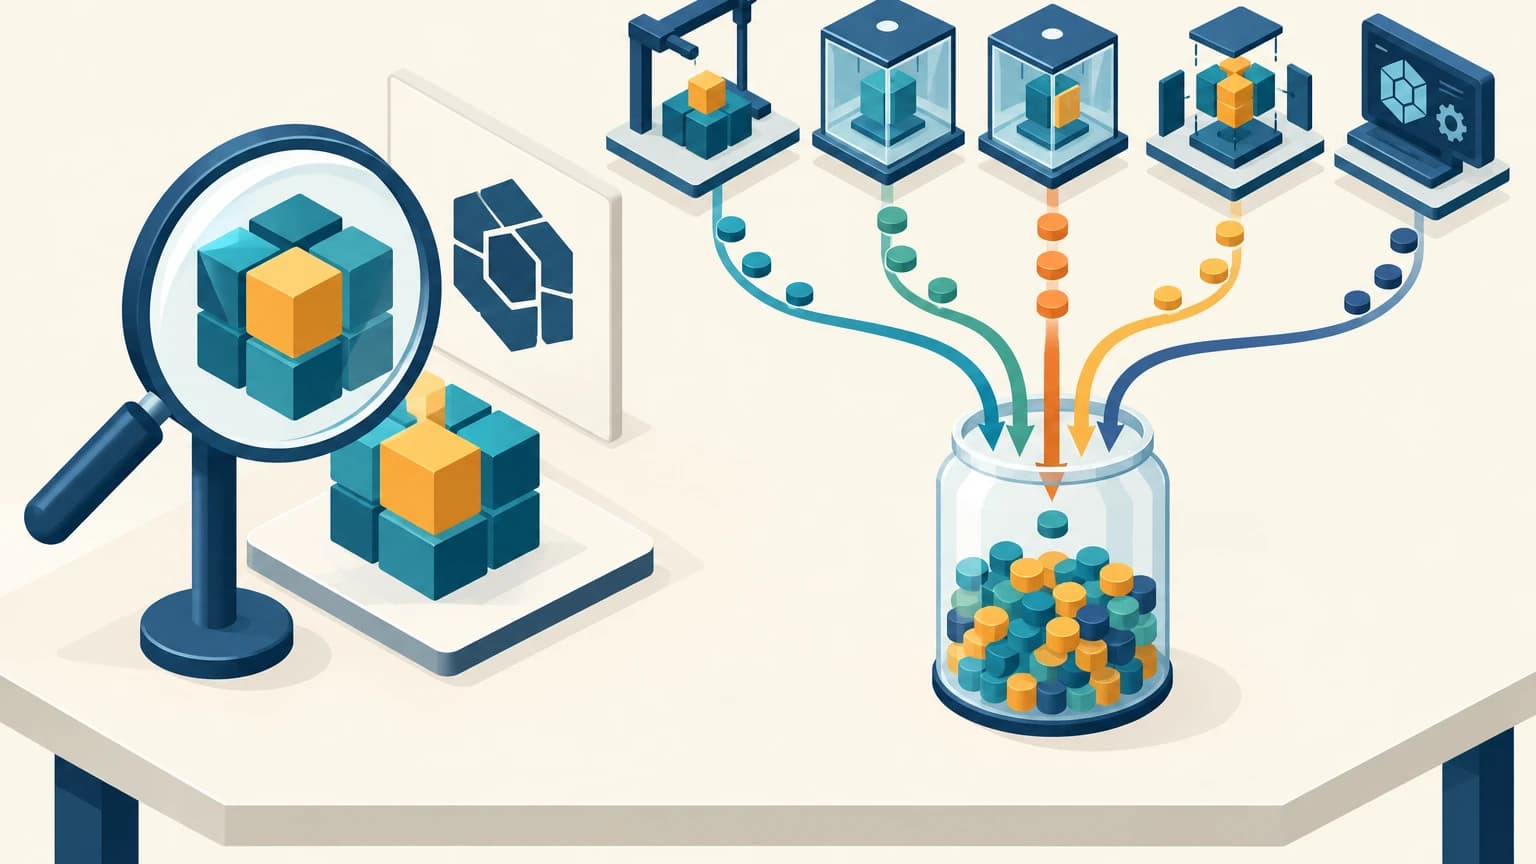
비용을 셀 때 흔히 놓치는 건 최종 실행 바깥의 실행들이에요. k=1만 해도 기준 실행 1회, 후보 시험 2회, 최종 실행 1회로 작업 실행이 모두 4회 들어갑니다. 여기에 제안·조합·회고에 드는 호출까지 더한 전체 비용과 소요 시간을 기록해 둬야, 점수 상승이 추가로 쓴 자원만큼 쓸모 있는지 판단할 수 있죠.
재현 조건 중에서는 편집 모델을 가장 먼저 확인하세요. 논문 주요 실험의 기본 편집 모델은 Claude Opus 4.8인데, 공개 설치 문서에서 HARNESS2_IMPROVER_MODEL의 기본값은 실행 모델로 되어 있습니다. 이 차이를 모른 채 돌리면 설정 차이를 개선 효과로 착각할 수 있어요. 작업, 실행 모델, 편집 모델, 평가자 조건을 고정한 상태에서 비교하고, 평가 전에는 공개 정답이나 채점 기준에 닿지 못하도록 네트워크도 막아 두어야 합니다.
Harness²는 Google이 공식 지원하는 제품이 아니고, 독립적인 재현이나 운영 환경에서의 장기 성능·비용 효과도 아직 확인이 필요한 상태예요. 도입을 검토한다면 같은 조건에서 얻은 점수와 전체 비용을 나란히 놓고 비교하는 쪽이 합리적입니다.
자주 묻는 질문
- Harness² 로컬 데모는 모델 인증 없이 실행할 수 있나요?
- 공개 저장소의 로컬 데모는 모델 인증 없이 결정론적 편집기와 실제 Python 실행으로 개선 흐름을 확인할 수 있습니다.
- Harness²의 k=1은 작업을 한 번만 실행한다는 뜻인가요?
- 단일 개선 단계인 k=1에도 기준 실행 1회, 후보 시험 2회, 최종 실행 1회로 총 4회의 작업 실행이 포함됩니다. 전체 비용에는 제안·조합·회고에 드는 호출도 더해야 합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.