Laya 고객문의 분류 평가: 공개 점수 해석과 한국어 검증 방법
Laya 고객문의 분류 평가의 76.4%가 의미하는 모델·데이터·정답 기준을 짚습니다. 실제 한국어 문의로 분류 정확도를 검증하고, 자동 배정 범위를 오분류율로 판단하는 방법을 설명합니다.
Hyuk · · 4분 · AI
핵심 요약
- 고객 서비스 정확도 76.4%는 영어용 전용 모델의 합성 데이터 평가 결과이므로 한국어 실제 문의의 분류 정확도로 해석하기 어렵습니다.
- 실제 한국어 문의와 사람이 검수한 기준 답으로 전체 정확도와 유형별 오분류를 함께 확인해야 합니다.
- `choice`의 `confidence`는 최상위 범주의 확률과 다르며, 자동 배정 범위는 자체 검증에서 확인한 오분류율을 기준으로 판단해야 합니다.
Laya 고객문의 분류 평가에서 전용 모델이 받은 고객 서비스 정확도 76.4%를 한국어 실제 문의의 유형 분류 정확도로 읽기는 어렵습니다. 영어용 모델이 합성 데이터에서 내린 여러 판단을 묶어 낸 결과이기 때문이에요. 도입을 판단하려면 쓸 모델과 분류 대상을 먼저 정하고, 실제 한국어 문의로 검증하는 과정이 필요합니다.
제가 점수보다 먼저 보라고 권하는 건 평가 질문입니다. 담당 부서 분류, 긴급도 평가, 해지 의사 탐지는 이름이 비슷해 보여도 서로 다른 작업이에요. 문의 유형에 따라 담당 부서를 배정하는 게 목적이라면 그 유형을 맞힌 결과만 따로 확인하는 편이 맞습니다.
76.4%는 무엇을, 어떤 정답과 비교한 숫자인가
76.4%는 laya-typed-decisions의 고객 서비스 영역 점수예요. 여기서 흔히 헷갈리는 게 전체 정확도 76.6%와의 구분인데, 전체 수치는 네 업무 영역의 테스트 400건, 판단 2,000개를 대상으로 나온 값입니다. 같은 벤치마크에서 기본 laya의 정확도는 36.2%로 보고됐습니다. 전용 학습 모델의 성적을 기본 모델에 그대로 옮겨 적용하면 안 되는 이유가 여기 있어요. 모델별 수치와 평가 범위는 Laya Typed-Decisions 모델 카드에서 확인할 수 있습니다.
그다음은 정답을 어떻게 만들었는지예요.
평가에 쓰인 LocalLLaMA/typed-decisions는 합성 데이터이고, 고객 서비스 영역은 학습 300건과 테스트 100건으로 구성됩니다. 기준 답은 교사 모델이 세 차례 출력한 확률분포를 평균해 만들었어요. Typed Decisions 데이터셋 카드도 점수를 교사 모델과의 일치도로 설명합니다. 사람이 검수한 실제 상담 정답을 얼마나 맞혔느냐와는 뜻이 다르다는 얘기죠. 여기에 영어용 모델이라는 조건까지 더하면, 공개 점수만 보고 한국어 표현이나 실제 서비스의 분류 기준을 잘 처리한다고 결론 내리기엔 근거가 모자랍니다.
한국어 문의로 직접 검증하는 방법
한국어 평가를 준비한다면 번역한 공개 예제보다 익명화한 실제 문의부터 확보하길 권합니다. 서비스마다 표현과 유형의 경계가 다르고, 실제 문의에는 생략과 오탈자가 섞여 들어오니까요. 자체 검증은 아래 순서로 설계해 볼 수 있어요.
- 실제 문의를 익명화하고 오탈자·짧은 문장·복합 요청을 포함한 평가 세트를 구성합니다.
- 문의 유형의 정의와 처리 규칙을 정한 뒤 사람이 검수한 기준 답을 붙입니다.
- 문의 유형은
choice로 평가하고, 같은 테스트 세트에서 범주 설명 보강 전후의 정확도와 유형별 오분류를 비교합니다.
순서상 놓치기 쉬운 부분은 복합 요청의 처리 규칙이에요. 이건 모델을 돌리기 전에 정해 둬야 합니다. choice는 주어진 범주 가운데 하나를 고르는 형식이라, “환불하고 구독도 해지해 주세요” 같은 문의가 들어오면 환불과 해지 중 무엇을 우선할지, 아니면 별도 복합 유형으로 받을지를 미리 결정해야 해요. 기준 답을 붙이는 사람마다 선택이 갈리면 모델이 틀린 건지 분류 체계가 모호한 건지 가려내기 어려워집니다.
범주 설명을 손볼 때는 이름만 바꾸기보다 포함 조건과 인접 유형과의 경계를 분명히 적는 쪽이 낫습니다. 어느 범주에도 들어맞지 않는 문의를 받아 줄 other 항목을 두는 것도 검토해 볼 만해요. 설명을 바꾼 효과를 비교하려면 테스트 문의와 기준 답은 그대로 유지해야 합니다.
전체 정확도만 보고 끝내지 마세요. 어떤 유형을 어떤 유형으로 잘못 분류하는지까지 봐야 자주 들어오는 유형의 성적에 묻힌 오류가 드러나고, 배정 기준을 고칠 근거도 생깁니다.
자동 배정은 어디까지 맡길까
분류 정확도를 확인했다면 이제 자동으로 맡길 범위를 정할 차례입니다. 자체 검증 데이터에서 임계값을 바꿔 가며 전체 문의 중 자동 배정 비율, 자동 배정된 문의 안에서의 오분류율, 상담원 이관 비율을 함께 봅니다. 자동 배정이 늘어날 때 오류가 얼마나 같이 늘어나는지 보고, 운영에서 받아들일 수 있는 수준을 고르는 방식이에요.
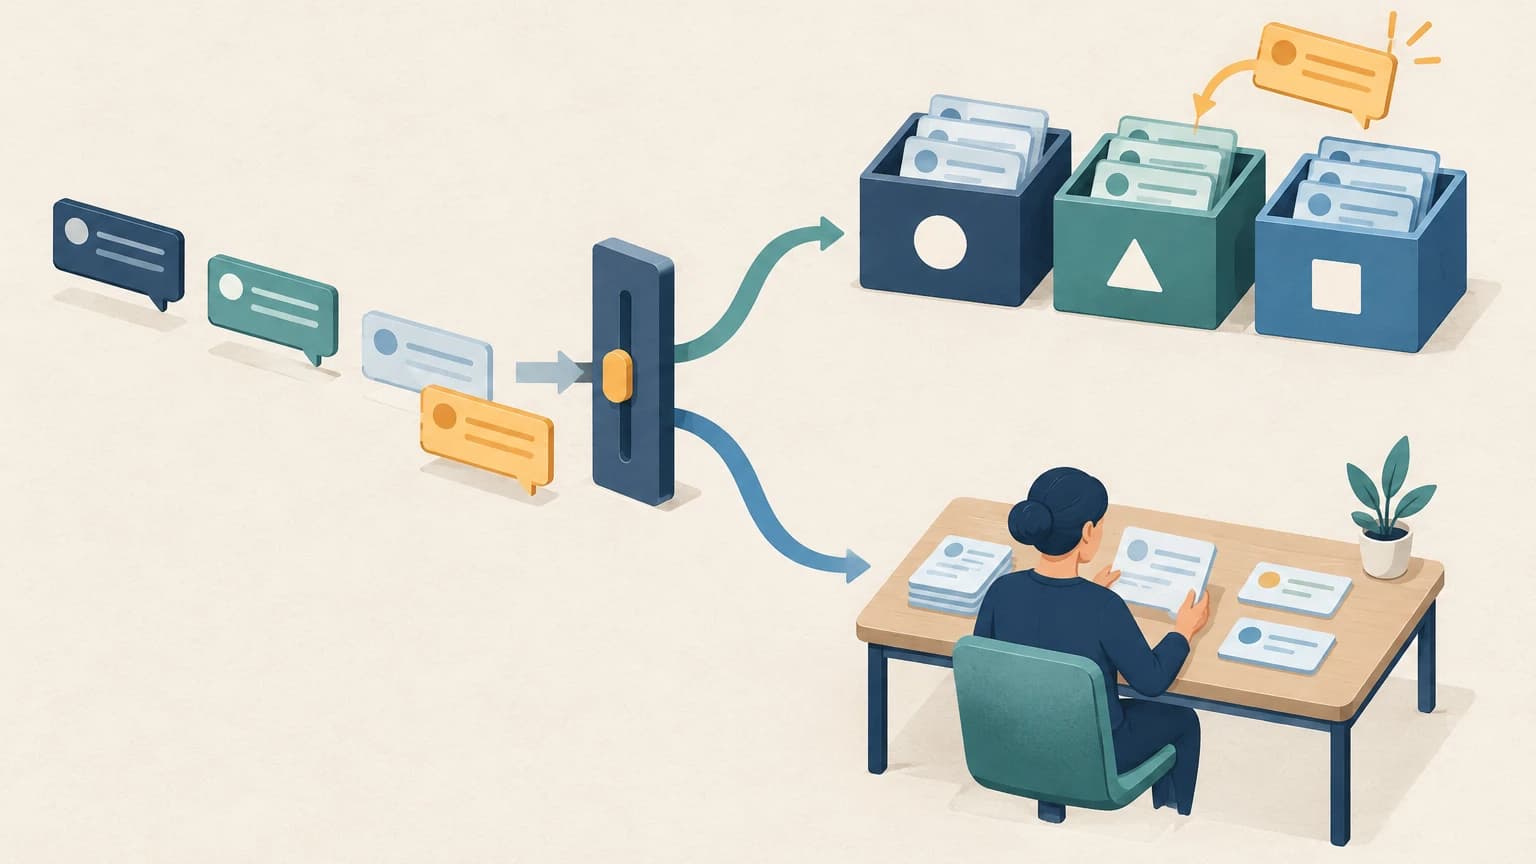
여기서 많이들 착각하는 게 choice의 confidence를 최상위 범주의 확률로 읽는 겁니다. 공식 문서는 이 값을 확률분포의 엔트로피로 계산한다고 설명해요. 엔트로피는 확률이 여러 범주에 얼마나 퍼져 있는지를 나타내는 값입니다. 그래서 결과를 재현하려면 임계값을 건 필드가 confidence였는지, 선택된 범주의 확률이었는지를 꼭 기록해 두세요. 출력값의 의미는 질문 유형 공식 문서에서 확인할 수 있습니다.
전용 모델 카드에도 과신과 확률 보정의 한계가 명시돼 있어요. 출력값이 높다는 것만으로 배정을 확정하지 말고, 그 기준을 통과한 실제 문의에서 어떤 오류가 나왔는지부터 보길 권합니다.
평가 결과에는 모델 리비전·패키지 버전·평가 데이터 버전을 함께 남겨 두세요. 별도의 한국어 실험을 하지 않은 상태라면 공개 점수와 한국어 운영 성능을 분리해서 보고, 도입 판단의 근거는 실제 문의 검증 결과로 삼아야 합니다.
자주 묻는 질문
- Laya 전용 모델의 평가 점수를 기본 모델에도 적용할 수 있나요?
- 전용 학습 모델의 성적을 기본 모델에 그대로 적용할 수는 없습니다. 같은 벤치마크에서 `laya-typed-decisions`의 전체 정확도는 76.6%, 기본 `laya`의 정확도는 36.2%로 보고됐습니다.
- 환불과 해지가 함께 들어온 문의는 어떻게 평가하나요?
- `choice`는 범주 하나를 고르므로 환불과 해지 중 무엇을 우선할지, 별도 복합 유형으로 받을지를 모델 실행 전에 정해야 합니다. 이 규칙에 따라 사람이 검수한 기준 답을 붙여야 모델 오류와 분류 기준의 모호함을 구분할 수 있습니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.