Bright Data로 아마존·쿠팡·다나와 가격 크롤링 자동화 만들기
Bright Data로 아마존·쿠팡·다나와의 가격 수집을 연결하고, 날짜별 저장·동일 상품 비교·텔레그램 알림을 구성하는 흐름을 설명합니다. 옵션 식별, 누락 재확인, 알림 중복 방지와 제품별 비용 기준도 함께 정리합니다.
Hyuk · · 5분 · AI
핵심 요약
- 아마존·쿠팡의 기존 스크래퍼와 다나와의 별도 수집기를 연결하려면 사이트별 입력과 반환 필드를 공통 형식에 맞춰야 합니다.
- 가격 비교는 같은 상품·옵션을 기준으로 하고, 가격과 구매 가능 상태를 따로 관측해야 합니다.
- 누락 상품은 재확인하고, 알림에는 중복 전송을 막는 기준과 확인된 변경 항목을 담습니다.
- 제품별 과금·결과 보관 기준이 다르므로 장기 가격 이력은 자체 저장소에 유지해야 합니다.
Bright Data로 이커머스 가격 크롤링 자동화를 구성할 때는 아마존·쿠팡은 Bright Data의 기존 상품 스크래퍼를 쓰고, 다나와는 별도 수집기를 만들어 연결합니다. 결과는 날짜별로 저장하고, 같은 상품의 이전 값과 비교해서 확인된 변화만 알림으로 보내요. 실행 흐름은 세 사이트가 함께 쓸 수 있습니다. 다만 사이트마다 입력값과 반환 필드가 다르기 때문에, 이를 공통 형식으로 바꾸는 연결 코드는 따로 작성해야 합니다.
가장 먼저 볼 것은 정말 같은 상품, 같은 옵션끼리 비교하고 있는지입니다.
용량이나 구성품이 다른 상품을 나란히 놓으면, 원래 있던 가격 차이를 가격 변동으로 읽기 쉽습니다. 그래서 처음에는 옵션까지 정해 둔 상품 URL 몇 개만으로 시작하는 편을 권해요. 비교 기준이 안정된 다음에 대상을 늘려야 수집이 빠진 것인지, 가격이 실제로 바뀐 것인지를 구분하기 쉽습니다.
사이트마다 무엇을 넣고 무엇을 돌려받나
아마존에서는 두 가지 수집 방식을 쓰임새에 따라 나눕니다. 키워드 검색은 추적할 상품을 찾는 데 쓰고, 상품 URL 수집은 대상을 정한 뒤 반복해서 관측하는 데 써요. 검색 결과는 실행할 때마다 달라질 수 있습니다. 반복 수집에서는 상품 식별자를 고정해 두는 편이 안전합니다.
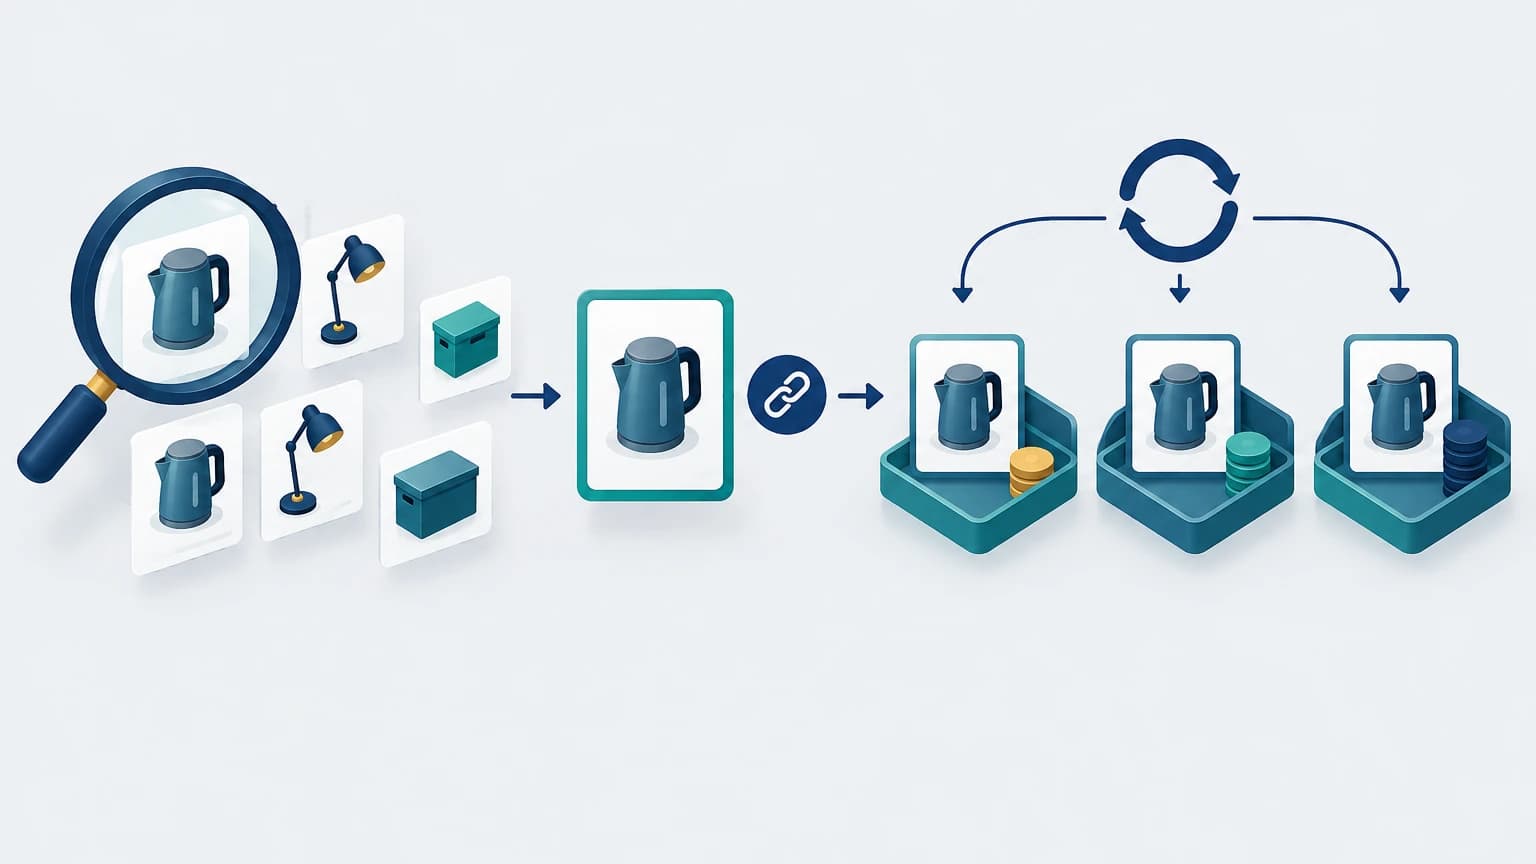
쿠팡에는 상품, 카테고리, 브랜드, 판매자 URL을 입력으로 받는 수집기가 각각 있습니다. 정해 둔 상품을 추적하려면 상품 URL 수집기의 입력 조건부터 확인하세요. 자동화에 붙이기 전에 제어판에서 한 번 수동으로 실행해 보고, 내려받은 결과에서 가격·옵션·구매 가능 상태가 어떤 값으로 나오는지 살펴보는 게 좋습니다. 이 단계를 건너뛰면 나중에 변환 코드를 짤 때 필드의 의미를 짐작으로 채우게 돼요.
다나와는 Scraper Studio로 별도 제작한 수집기 사례로 소개됩니다. Scraper Studio에서 공식적으로 확인되는 기능은 자연어나 JavaScript로 맞춤 수집기를 만들고 출력 스키마를 검토하는 것까지예요. 사례에 나온 수집기를 그대로 재사용할 수 있는지는 따로 확인해야 합니다. 직접 만든다면 Scraper Studio 공식 문서를 기준으로 필요한 필드와 실행 방식을 정하세요.
결과를 어떻게 저장하고 무엇끼리 비교하나
기존 스크래퍼는 비동기로 실행되며, 아래 순서로 연결합니다. 여기서 snapshot_id는 한 번의 수집 결과를 조회할 때 쓰는 식별자입니다.
- Bearer API 키와 선택한
dataset_id로POST /datasets/v3/trigger를 호출합니다. - 응답으로 받은
snapshot_id를 자체 저장소에 기록합니다. GET /datasets/v3/progress/{snapshot_id}로 상태를 확인합니다.- 상태가
ready가 되면GET /datasets/v3/snapshot/{snapshot_id}로 결과를 내려받습니다. - 원본과 비교용 데이터를 저장하고 이전 관측값과 대조합니다.
예약 실행은 1번에서 시작하면 됩니다. 흔히 헷갈리는 부분은 요청을 보낸 시점을 수집 완료로 처리하는 경우예요. 완료 여부는 3·4번을 거쳐 결과를 실제로 받은 다음에 판단해야 합니다. API의 세부 조건은 공식 참고 자료에서 확인할 수 있어요. 다나와 맞춤 수집기는 실행 인터페이스가 다를 수 있으니 따로 확인한 뒤 연결하세요.
공통으로 저장할 항목은 사이트, 상품·옵션 식별자, 수집 시각, 통화, 판매가와 표시 기준가격, 재고·수집 상태 정도를 권합니다. 이 형식은 우리가 정하는 자체 저장 형식이라서, 수집기마다 다른 필드명과 의미에 맞춰 변환해 넣어야 해요. 날짜별 원본도 함께 남겨 두세요. 변환 과정에서 오류가 생겼을 때 원본에서 다시 비교할 수 있습니다.
쿠팡 URL은 정리할 때 특히 조심해야 합니다. URL에 붙은 itemId·vendorItemId가 관측 대상을 구분하는 데 필요한지 먼저 확인한 뒤 처리하세요. 쿼리 문자열을 통째로 지우면 옵션이나 판매 단위를 구분하는 정보까지 사라질 수 있습니다. 또 가격이 표시되어 있어도 실제로는 구매할 수 없는 상태일 수 있으니, 가격과 구매 가능 상태는 따로 비교하는 게 맞아요.
빠진 상품은 다시 확인하고, 확인된 변화만 알리기
반환된 목록은 실행 전에 정해 둔 기대 상품 목록과 맞춰 봅니다. 빠진 상품은 일단 '수집 미확인'으로 기록하고, 여러 번 반복해서 빠지면 '재확인 필요'로 올리는 방식을 권해요. 누락 횟수만 보고 판매가 끝났다고 확정하지는 마세요. 해당 상품만 다시 실행해서 상태를 확인하는 쪽이 정확합니다. 날짜만 보고 "이미 돌린 작업"이라며 건너뛰는 구조라면 부분 실패를 복구하기가 어려워집니다.
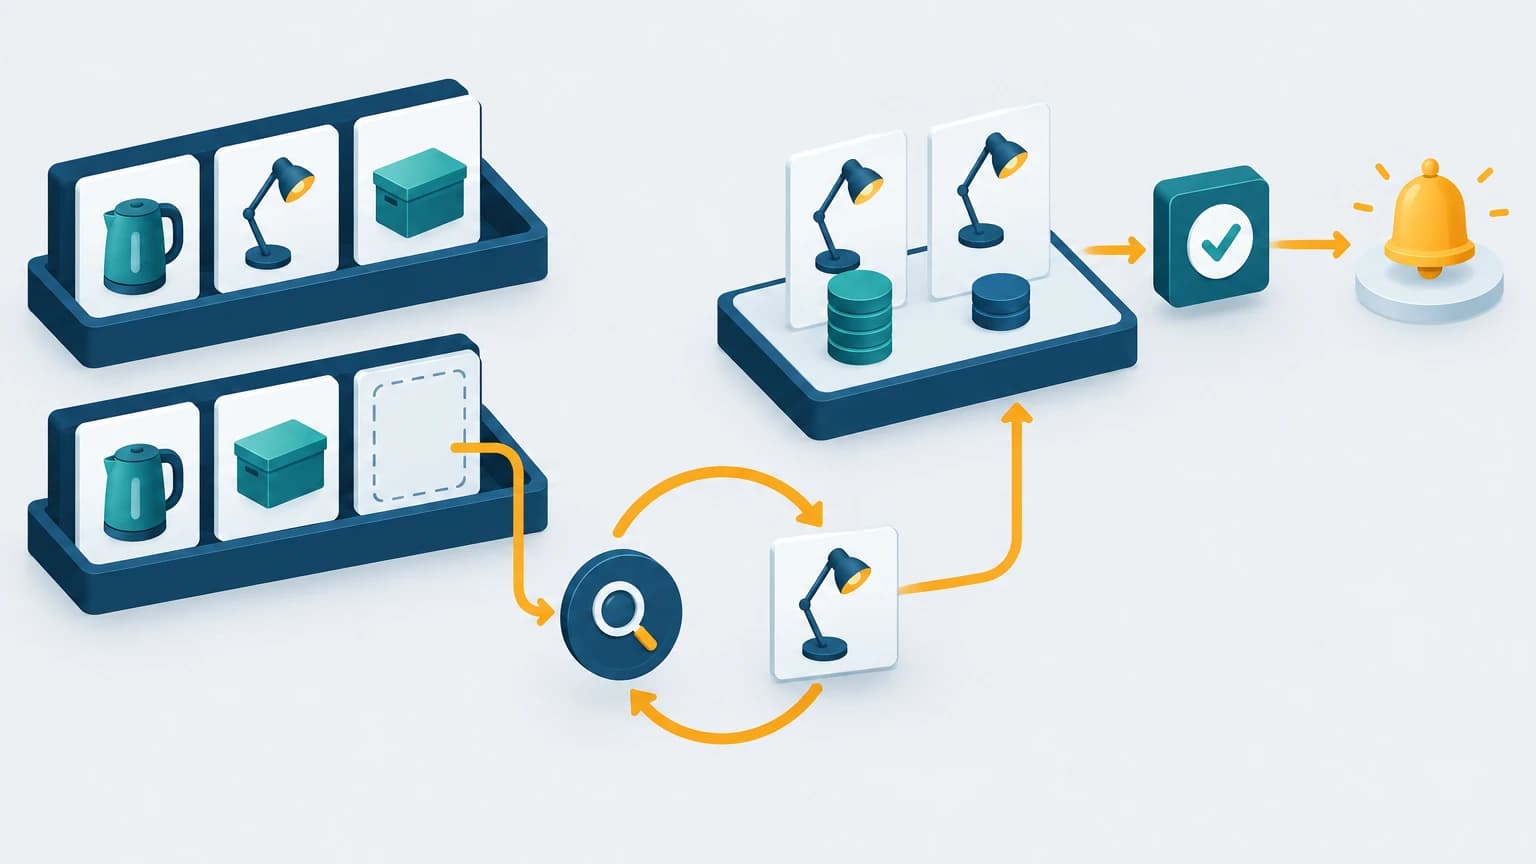
재실행 여부는 상품별 성공 상태로 판단하세요. 알림 쪽에는 이미 보낸 변화인지 가려낼 중복 방지 기준을 둡니다.
다나와의 최저가가 올랐을 때는 원인이 하나로 정해지지 않습니다. 같은 판매자가 가격을 올렸을 수도 있지만, 더 싼 판매처가 목록에서 빠져도 같은 결과가 나올 수 있어요. 판매처별 관측값이 없다면 알림 문구는 '최저가 상승'까지만 쓰는 편이 정확합니다.
텔레그램 전송은 별도 단계로 분리합니다. Bot API의 sendMessage에 chat_id와 text를 넘기는 방식이에요. 메시지에는 이전 값과 현재 값, 관측 시각, 상품 링크, 확인된 변경 항목을 담습니다. 비교 자체는 명시적인 규칙으로 처리하고, AI는 확인된 차이를 읽기 쉬운 문장으로 정리하는 데만 쓰는 걸 권합니다. 가격 차이 하나만 보고 '할인 종료' 같은 원인까지 붙이면 관측한 사실과 추정이 한 메시지 안에서 섞여 버리거든요.
비용과 결과 보관 기간은 제품마다 따로 확인해야 합니다. 과금 기준부터 달라요. 기존 스크래퍼는 성공적으로 전달된 레코드를 기준으로, Scraper Studio는 페이지 로드를 기준으로 과금합니다. 그래서 상품 수에 실행 횟수를 곱하는 식으로 공통 비용을 계산하기는 어렵습니다. 결과 보관 기준도 제품마다 다르기 때문에, 장기간의 가격 이력은 자체 저장소에 내려받아 유지해야 합니다.
자주 묻는 질문
- 쿠팡 상품 URL의 쿼리 문자열을 삭제해도 되나요?
- `itemId`·`vendorItemId`가 관측 대상 구분에 필요한지 먼저 확인해야 합니다. 쿼리 문자열을 모두 지우면 옵션이나 판매 단위 구분을 잃을 수 있습니다.
- 수집 결과에 상품이 없으면 판매 종료로 처리해도 되나요?
- 빠진 상품은 ‘수집 미확인’, 반복 누락은 ‘재확인 필요’로 기록하고 해당 상품을 재실행해 상태를 확인하는 편이 좋습니다. 누락 횟수만으로 판매 종료를 확정하지 마세요.
- 다나와 최저가가 오르면 판매자가 가격을 올린 건가요?
- 더 저렴한 판매처가 목록에서 빠져도 최저가가 상승할 수 있습니다. 판매처별 관측값이 없다면 알림은 ‘최저가 상승’까지만 설명하는 편이 정확합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.