Claude Code auto-compact: 장기 세션 토큰 사용량을 이해하고 관리하는 방법
Claude Code auto-compact가 문맥을 줄여도 누적 사용량이 늘어나는 이유와 입력·캐시 토큰 집계 방식을 설명합니다. 압축 기준과 재개 메모를 활용하고, 200K·400K·기본값을 작업 완료 비용과 품질로 비교하는 방법을 정리했습니다.
Hyuk · · 4분 · AI
핵심 요약
- 자동 압축은 다음 요청의 문맥을 줄이지만 이미 발생한 누적 사용량을 되돌리지는 않습니다.
- 총 입력량은 일반 입력·캐시 쓰기·캐시 읽기를 합산하고 모델 요청 단위로 분석해야 합니다.
- 400K는 공식 최적값이 아니므로 같은 산출물의 검증 완료까지 드는 비용과 품질로 비교해야 합니다.
Claude Code auto-compact는 문맥을 줄여도 누적 사용량을 되돌리지는 않습니다
Claude Code auto-compact는 다음 요청에 전달할 문맥을 줄이는 기능입니다. 이미 처리한 사용량은 남고, 후속 요청에 문맥이 반복 입력되면 누적 사용량은 늘어납니다. 압축 기준 조정과 작업 재개 메모를 활용하되, 400K를 보편적인 절약 기준으로 삼지 말고 작업 완료까지의 비용과 품질을 비교해야 합니다.
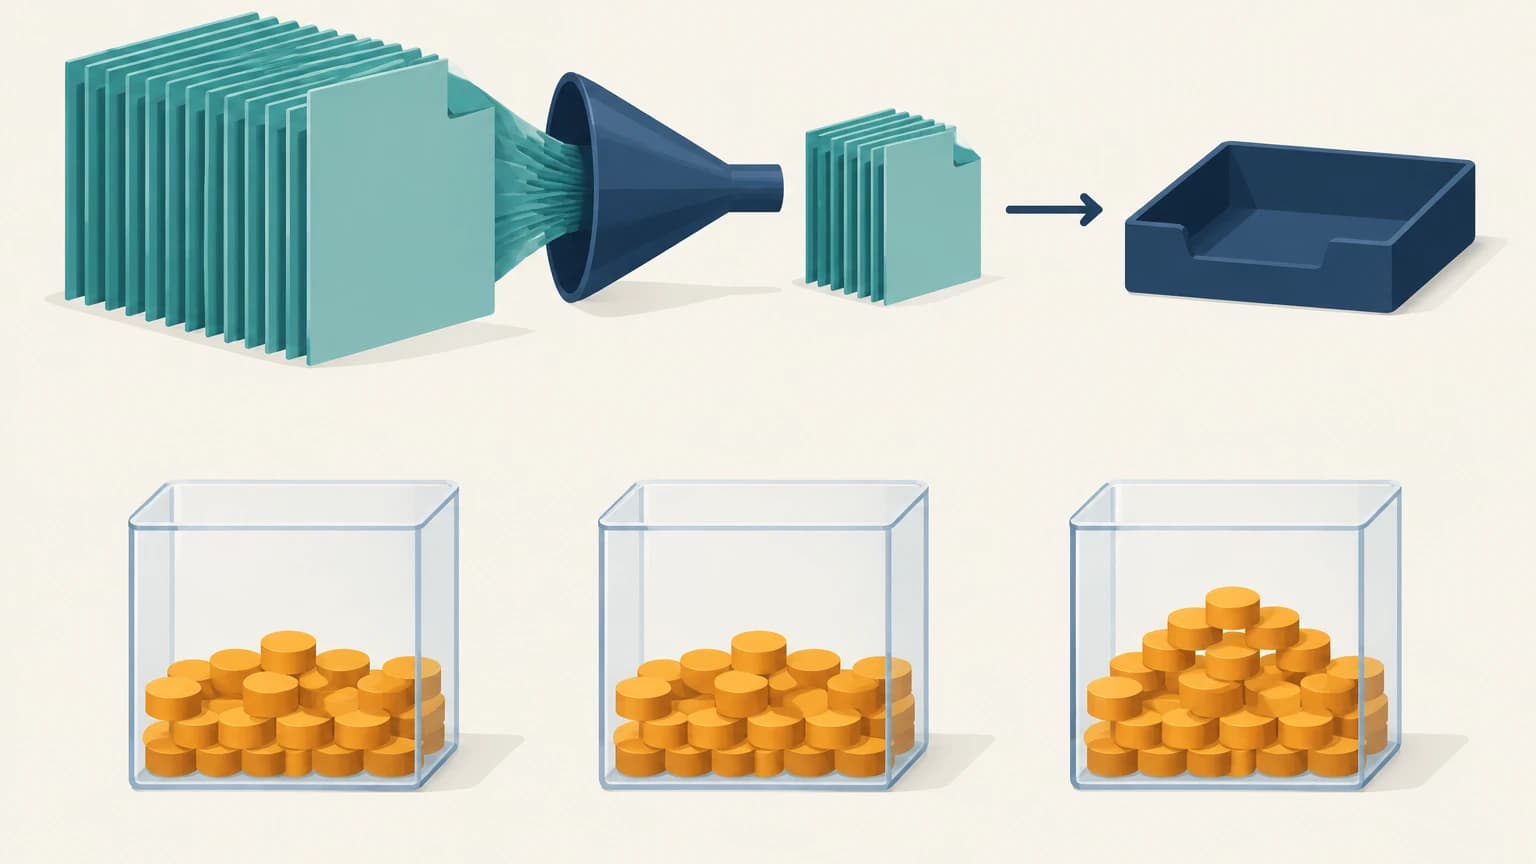
현재 컨텍스트는 한 요청에서 참고하는 문맥이며, 누적 사용량은 여러 요청에서 처리한 토큰의 합계입니다. 캐시는 반복 입력의 비용을 낮추지만 문맥 자체를 없애지는 않습니다. 공식 사용량 안내
압축 요청과 반복 입력을 나눠 살펴봅니다
Claude Code는 한도에 가까워지면 오래된 도구 출력을 먼저 정리하고, 필요하면 대화를 요약합니다. 압축 후에도 시스템 지침이 유지되고 파일이 재주입됩니다. 컨텍스트 처리 방식
| 입력 항목 | 의미 |
|---|---|
일반 입력 input_tokens | 캐시 쓰기·읽기에 포함되지 않은 입력 |
캐시 쓰기 cache_creation_input_tokens | 재사용할 문맥을 저장하는 입력 |
캐시 읽기 cache_read_input_tokens | 저장한 문맥을 다시 사용하는 입력 |
총 입력은 세 항목의 합계입니다. 캐시 읽기도 유료이며 컨텍스트를 차지하므로 일반 입력만 보면 처리량을 빠뜨립니다. 캐시 토큰 집계
100K의 캐시 문맥을 10번 읽으면 누적 캐시 읽기는 1M입니다. 설명용 산술이며, 현재 컨텍스트가 1M이라는 뜻은 아닙니다.
분석은 사용자 메시지 수보다 도구 호출을 포함한 모델 요청 단위로 진행합니다. 압축 전 반복 입력, 요약 요청, 압축 후 캐시 재구축·파일 재읽기를 나눠 기록해야 합니다. 압축 직후 증가분만으로 원인을 단정하기는 어렵습니다. 비용 관리 안내
압축 기준을 조정하고 재개 메모를 남깁니다
지원되는 환경에서는 /autocompact 400k로 기준을 설정하고 /autocompact auto로 모델 기본값에 복귀합니다. 설정값은 모델의 컨텍스트 한도로 제한되며, 400K는 공식 최적값이 아닌 비교 후보입니다.
리서치 기준일은 2026-10-14입니다. 약 967K라는 기본 압축 시점은 네이티브 1M 모델의 근삿값입니다. v2.1.288부터 /autocompact 설정은 현재 모델별로 저장되므로 모델 변경 시 적용값을 확인해야 합니다. 압축 기준 설정 · 모델별 설정과 기본값
같은 작업의 문맥을 정리할 때는 /compact, 관계없는 새 작업으로 넘어갈 때는 /clear를 사용합니다. 작업 전환 안내
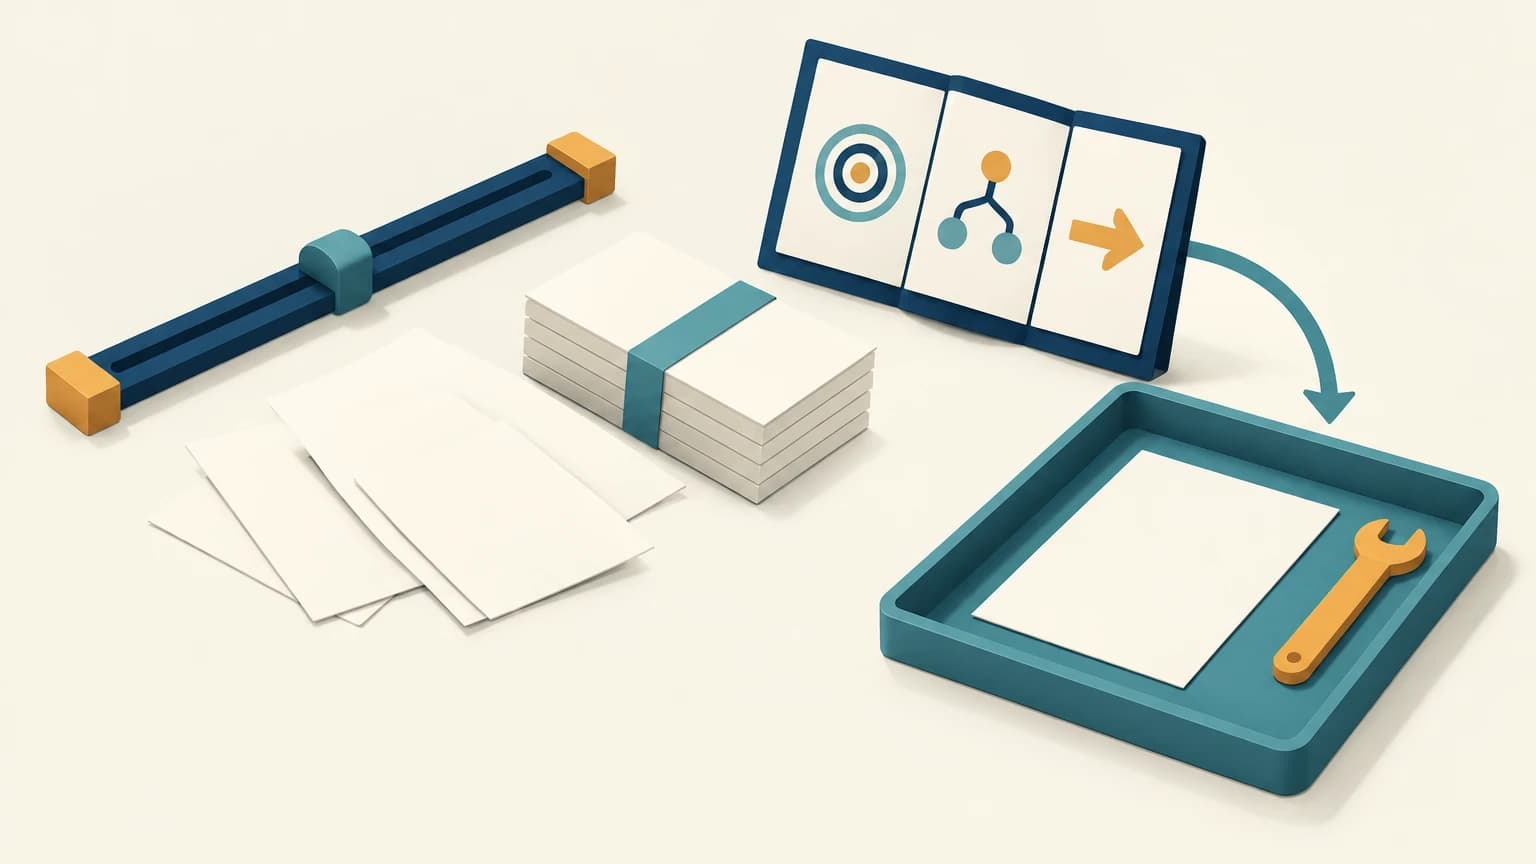
전환 전에는 다음 재개 메모를 남기기를 권합니다.
- 목표와 완료 조건
- 근거 파일 경로와 필요한 구간
- 결정 사항과 선택 이유
- 테스트 실행 명령과 결과
- 남은 작업과 다음에 읽을 파일
큰 원문·로그는 복사보다 저장 위치를 적고 필요한 구간을 읽도록 안내합니다. 요약에서 세부 사항이 빠질 가능성에 대비하는 절차로, 절감 효과는 별도 측정이 필요합니다.
200K·400K·기본값은 완료 비용과 품질로 비교합니다
기준은 대화 횟수가 아니라 같은 산출물의 검증 완료입니다. 아래는 실험 설계이며, 세 설정의 우열을 보여주는 실측 결과는 없습니다.
| 비교 항목 | 기록·통제 방법 |
|---|---|
| 실험군 | 동일한 1M 지원 모델에서 200K·400K·auto 비교 |
| 시작 조건 | 같은 저장소 커밋·과제·지침·도구 구성으로 새 세션 시작 |
| 실행 조건 | 모델 ID·버전·제공자·thinking·effort 고정 |
| 토큰·비용 | 요청별 일반 입력·캐시 쓰기·읽기·출력 집계, 캐시 적중 기록 |
| 재탐색 | 압축 후 같은 파일 재읽기·검색 반복 기록 |
| 품질 | 동일 테스트 통과 여부·요구사항 누락·수정 횟수 비교 |
조기 압축은 후속 입력을 줄일 수 있지만 재탐색 비용도 생길 수 있습니다. 압축이 없는 짧은 과제와 문맥이 크게 쌓이는 과제는 구분해서 해석해야 합니다.
/usage의 세션 달러 비용 추정치는 Pro·Max 구독의 실제 청구액이 아니므로, 토큰 집계·비용 추정치·구독 사용 정보를 구분해야 합니다. 사용량과 비용 확인
자주 묻는 질문
- 캐시 읽기가 누적 1M이면 현재 컨텍스트도 1M인가요?
- 아닙니다. 100K의 캐시 문맥을 10번 읽어도 누적 캐시 읽기가 1M일 뿐, 현재 컨텍스트가 1M이라는 뜻은 아닙니다.
- 모델을 바꾸면 자동 압축 설정도 확인해야 하나요?
- v2.1.288부터 `/autocompact` 설정은 현재 모델별로 저장되므로 모델을 바꿀 때 적용값을 확인해야 합니다.
- 같은 작업을 이어갈 때 `/compact`와 `/clear` 중 무엇을 쓰나요?
- 같은 작업을 이어가며 문맥을 정리할 때는 `/compact`를 사용합니다. `/clear`는 관계없는 새 작업으로 넘어갈 때 사용합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.