Claude Code로 롱폼 영상을 릴스로: 전사부터 검수용 MP4까지
촬영해 둔 롱폼 영상을 Claude Code와 로컬 도구로 릴스(숏폼)로 재편집하는 자동화 설계안입니다. 음성 추출부터 전사, 구간 선택, 렌더, 사람 검수까지 도구별 역할, 파일과 타임코드 명세, 검수 및 실행 환경 기록 기준을 정리합니다.
Hyuk · · 5분 · AI
핵심 요약
- 이 글은 이미 촬영해 둔 롱폼 영상(인터뷰, 강의, 라이브 등)을 릴스로 잘라 재편집하는 흐름을 다룹니다. 주제 텍스트만으로 릴스를 처음부터 만드는 흐름은 구조가 달라 따로 다룹니다.
- 첫 목표는 음성 추출부터 렌더링까지 연결해 검수용 MP4와 자막, 출처표를 함께 생성하는 상태로 잡기를 권합니다.
- Claude Code는 실행 조정과 구간 선택을 맡고, FFmpeg는 음성 추출과 영상 출력을, whisper.cpp는 전사를 맡도록 구성합니다.
- 장면 명세에 원본 구간과 출력 구간의 대응 관계를 남겨야 편집 후 자막 오류의 원인을 좁힐 수 있습니다.
- 자동화 효과는 도구 처리시간과 사람 수정시간을 따로 기록해 판단해야 합니다.
길게 찍어 둔 영상이 있다면, 그 안에서 쓸 만한 구간을 골라 세로형 릴스로 다시 편집하는 작업을 Claude Code로 자동화할 수 있습니다. Claude Code가 처리 단계를 조정하고 전사문에서 쓸 구간을 고르며, 음성 추출과 전사, 영상 출력은 로컬 도구가 맡는 구성이에요.
첫 목표는 원본 영상 → 음성 추출 → 전사 → 구간 선택과 대본 정리 → 장면 구성 → 렌더 → 사람 검수를 한 줄로 이어, 검수 폴더에 MP4와 자막, 출처표가 함께 떨어지는 상태로 잡기를 권해요. 자동화가 아무리 잘 돌아도 사람이 자막을 고치고 소재 출처를 확인할 수 있어야 검수를 끝낼 수 있기 때문입니다.
이 흐름은 말소리가 담긴 원본 영상이 있다는 것을 전제로 합니다. 주제나 키워드만 가지고 대본과 음성(TTS), 화면 소재를 새로 만드는 릴스 제작은 전사가 필요 없고 다루는 문제도 달라서, 후속 글에서 따로 정리합니다.
누가 무엇을 맡는지부터 나눕니다
Claude Code에는 코드와 구조화 명세 작성, 실행 단계 조정, 그리고 전사문에서 릴스로 쓸 구간 후보를 고르는 일을 맡기면 됩니다. claude -p로 비대화형 실행을 하고 JSON이나 JSON Schema 기반으로 출력을 받으면, 고른 구간이나 장면 명세를 다음 프로그램에 그대로 넘길 수 있어요. 어떤 옵션을 쓸지는 Claude Code 자동 실행 문서에서 확인하세요.
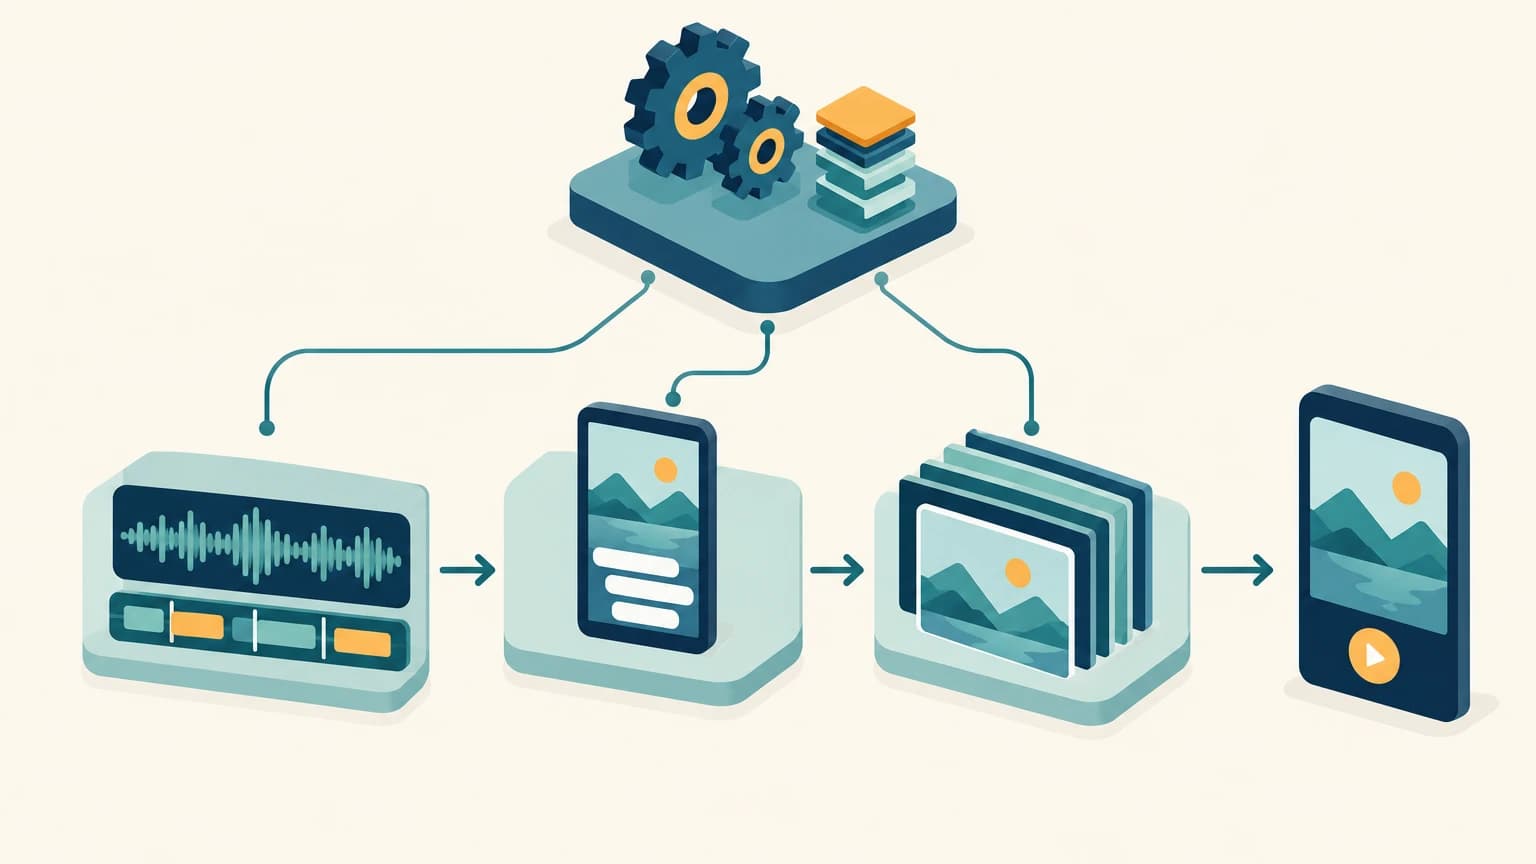
FFmpeg는 흐름의 처음과 끝에 모두 등장합니다. 처음에는 원본 영상에서 전사용 음성을 뽑아요. whisper.cpp는 영상을 바로 읽지 않고 16kHz 모노 WAV를 입력으로 받기 때문에 이 단계가 꼭 필요합니다. 끝에서는 고른 구간을 잘라 이어 붙이고, 가로 영상을 9:16 세로 화면으로 리프레이밍하고, 자막을 입혀 MP4로 출력합니다. 음성인식은 Whisper의 C/C++ 구현인 whisper.cpp에 맡기면 됩니다.
이 도구들을 부르는 제어 스크립트는 Python의 subprocess든 Node.js의 child_process든, 유지보수하기 편한 쪽을 고르면 충분해요. Playwright는 웹 화면 캡처를 보조 소재로 끼워 넣을 때만 추가하면 됩니다. 원본 영상만 잘라 쓰는 흐름이라면 처음부터 넣을 이유가 크지 않습니다.
여기서 흔히 섞이는 부분이 있어요. 제작 프로그램을 개발할 때 Claude Code를 쓰는 것과, 영상을 만들 때마다 모델을 호출하는 것은 서로 다른 선택입니다.
제가 권하는 방식은 구간 선택이나 대본 정리처럼 모델의 판단이 필요한 단계에서만 호출하고, 매번 똑같이 도는 음성 추출과 렌더 작업은 스크립트로 처리하는 쪽입니다. 그리고 전사와 렌더링을 로컬에서 한다고 해서 데이터가 밖으로 나가지 않는다고 단정하면 곤란해요. Claude에 넘길 전사문과 로그의 범위는 따로 정해 두어야 하고, 실제로 어떤 데이터가 오가는지는 설정과 실행 기록으로 확인하세요.
설치보다 먼저 파일 명세와 시간 정보를 정합니다
무엇을 설치할지보다 먼저 정해야 할 것이 단계 사이에 주고받을 파일 명세입니다. 앞 단계의 결과를 다음 단계가 읽지 못하면 자동화는 거기서 끊기거든요. 폴더마다 역할을 나눠 두면 원본과 수정본, 검수 대상을 헷갈릴 일도 줄어듭니다.
폴더는 네 개면 충분합니다.
input/: 말소리가 담긴 원본 롱폼 영상과 파일 식별자, 출처 URL, 사용 권리 확인 상태work/: 추출한 음성(WAV), 전사문과 타임코드, 선택한 구간 목록, 수정 대본, 장면 명세review/: 검수용 MP4와 자막, 출처표, 실행 로그output/: 사람 검수를 마친 승인본만
이 중 가장 먼저 들여다볼 곳은 전사문의 시간 정보입니다. 롱폼에서 릴스를 만들 때는 거의 항상 문장을 지우고, 구간을 건너뛰고, 순서를 바꾸게 돼요. 문장을 읽기 좋게 다듬는 일과 자막을 영상에 맞추는 일은 별개로 봐야 합니다. 문장을 지우거나 순서를 바꾸는 순간, 원본 타임코드를 완성 영상에 그대로 적용하기가 어려워집니다.
그래서 장면 명세에는 사용할 소재, 원본 구간, 출력 구간, 화면 문구를 각각 따로 적어 두기를 권합니다. 원본 구간은 롱폼의 어디서 가져왔는지를, 출력 구간은 완성된 릴스의 어디에 놓을지를 뜻해요. 두 구간이 어떻게 대응하는지 남아 있어야 편집 뒤 자막이 어긋났을 때 원인을 빨리 좁힐 수 있습니다. 시간 변환 로직은 구현만 하고 끝내지 말고, 실제 영상과 자막을 나란히 대조해 검증하세요.
효과는 검수 결과와 실행 기록으로 판단합니다
처음 시험해 볼 때는 원본 롱폼 10개 정도를 제안합니다. 이때 오류를 하나로 뭉뚱그리지 말고 전사 오류, 구간 선택 오류(맥락이 끊기거나 핵심이 빠진 경우), 자막 표시나 싱크 오류, 렌더 실패로 나눠 기록하세요. 도구 처리시간과 사람 수정시간도 따로 적어야 해요. 렌더가 아무리 빨라도 자막 고치는 데 오래 걸린다면, 손볼 곳은 렌더가 아니라 전사나 자막 단계입니다. 한국어 오류를 비교할 때는 띄어쓰기와 숫자, 문장부호를 어떻게 처리할지 규칙부터 정해 두고, 고유명사와 수치 오류는 별도로 남겨 두는 편이 쓸모가 많습니다.
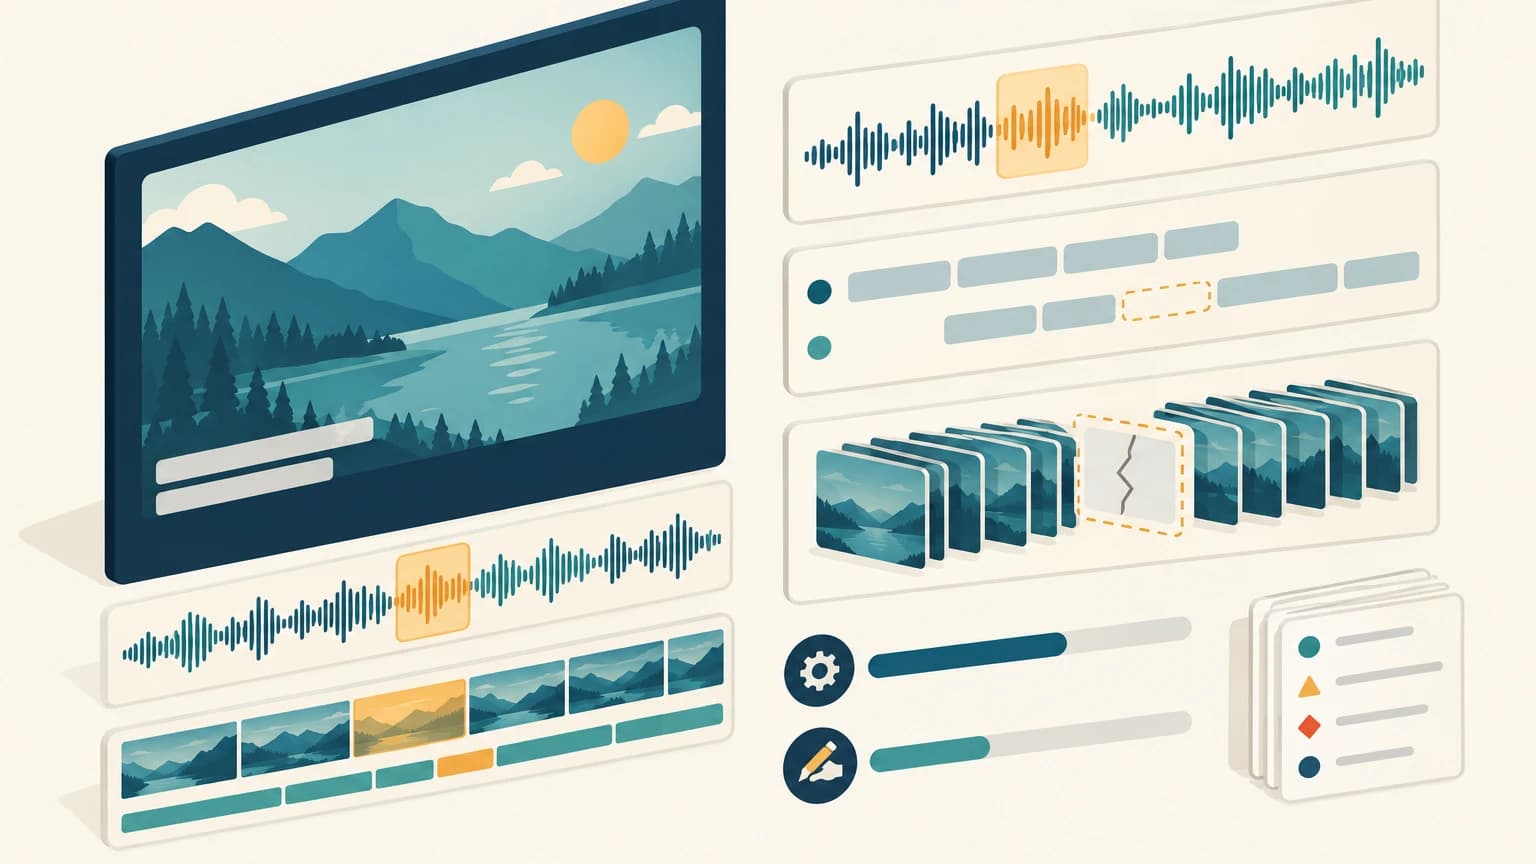
사람은 자막, 사실관계, 소재 권리, 개인정보를 확인한 뒤 그 결과물에 승인을 연결해야 합니다. 롱폼에서 잘라 낸 구간은 앞뒤 맥락이 빠지면서 원래 발언 취지와 다르게 읽힐 수 있으니, 이 부분도 검수 항목에 넣어 두세요. 어느 파일을 승인했는지가 분명해야 수정본과 승인본이 섞이지 않아요. 첫 흐름은 검수를 마친 파일을 output/으로 넘기는 데서 멈추는 게 좋습니다. 자동 게시 정책과 API 구현은 따로 다룰 주제예요.
나중에 같은 결과를 다시 내려면 설치 목록과 실행 환경을 함께 보관해야 합니다. 여기서 Brewfile을 버전 고정 수단으로 착각하기 쉬운데, Brewfile은 설치 목록을 관리하는 용도이고 Homebrew Bundle 공식 문서에 따르면 버전 고정용 잠금 파일을 지원하지 않습니다. 실제 도구 버전, FFmpeg 빌드 옵션, whisper.cpp 커밋과 모델 파일 식별값, 사용한 폰트, 렌더 명세까지 함께 남겨 두세요. 언어 패키지의 잠금 파일은 시스템 도구 환경 기록과 구분해서 관리하면 됩니다.
지금까지 설명한 구성은 실행 재현 전의 설계안이에요. 한국어 정확도나 제작시간이 얼마나 줄어드는지는 사용할 모델과 하드웨어, 음질 조건을 먼저 정하고, 처리시간과 사람 수정시간을 직접 측정해서 판단해야 합니다.
자주 묻는 질문
- 촬영한 영상 없이 주제만 가지고도 이 흐름을 쓸 수 있나요?
- 말소리가 담긴 원본 영상을 전제로 합니다. 주제 텍스트로 시작한다면 전사할 음성이 없으니 전사 단계는 빠지지만, 대신 대본을 새로 작성해야 합니다. 그다음 대본으로 TTS 음성을 만들고, 화면 소재를 마련하고, 대본 기반으로 자막을 생성하는 것이 중심이 됩니다. 구조가 달라 후속 글에서 따로 다룹니다.
- 원본 영상을 whisper.cpp에 바로 넣으면 안 되나요?
- whisper.cpp는 16kHz 모노 WAV 음성을 입력으로 받습니다. FFmpeg로 원본 영상에서 음성을 먼저 추출해 work/에 저장한 뒤 전사하는 단계를 두세요.
- 릴스를 제작할 때마다 Claude 모델을 호출해야 하나요?
- 제작 프로그램 개발에 Claude Code를 쓰는 것과 매 제작 실행마다 모델을 호출하는 것은 별도 선택입니다. 구간 선택이나 대본 정리처럼 모델 판단이 필요한 단계에서 호출하고, 고정된 음성 추출과 렌더 작업은 스크립트로 실행하는 구성을 권합니다.
- 전사문의 타임코드를 편집한 영상에 그대로 써도 되나요?
- 문장을 삭제하거나 순서를 바꾸면 원본 타임코드를 그대로 적용하기 어려워집니다. 장면 명세에 원본 구간과 출력 구간의 대응 관계를 남기고, 실제 영상과 자막을 대조해 시간 변환 로직을 검증해야 합니다.
- Brewfile만 보관하면 실행 환경을 재현할 수 있나요?
- Brewfile은 설치 목록 관리용이며 버전 고정용 잠금 파일을 지원하지 않습니다. 실제 도구 버전, FFmpeg 빌드 옵션, whisper.cpp 커밋과 모델 파일 식별값, 폰트, 렌더 명세도 함께 남기기를 권합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.