Docling으로 문서 구조를 보존해 AI 입력을 만드는 변환·청킹 방법
Docling 문서 구조 보존을 위해 변환 결과의 제목·표·읽기 순서를 확인하고, HybridChunker로 제목 맥락을 포함한 입력을 구성하는 방법을 설명합니다. JSON 보관과 제목 계층·표 오류의 확인 지점도 짚습니다.
Hyuk · · 4분 · AI
핵심 요약
- 청킹 전에 추출된 제목·표·읽기 순서를 원본과 대조해야 잘못 연결된 본문이 모델에 전달되는 일을 줄일 수 있습니다.
- Markdown과 구조화된 JSON을 함께 보관하면 내용을 확인하고 추출 구조를 후속 재처리에 활용할 수 있습니다.
- 임베딩 입력과 토큰 길이 확인에는 contextualize(chunk)로 맥락을 덧붙인 문자열을 사용합니다.
Docling으로 문서 구조를 보존하려면 '문서 변환 → 구조 검토 → 청킹 → 모델 입력 구성' 순서로 진행하면 됩니다. 추출된 제목·표·읽기 순서를 원본과 대조한 다음, 제목 맥락을 포함한 텍스트를 모델에 넘기는 흐름이에요. 여기서 청킹은 문서를 모델이 처리할 수 있는 조각으로 나누는 과정을 말합니다. 추출 구조를 먼저 살펴야 잘못 연결된 본문이 AI 입력에 섞이는 일을 줄일 수 있어서 이 순서를 권합니다.
Markdown과 JSON을 둘 다 남겨 두는 이유
DoclingDocument는 본문·표·그림, 섹션 계층, 머리말·꼬리말 구분과 출처 정보를 표현하고, 확보된 좌표도 함께 담습니다. 사람이 눈으로 내용을 확인하기에는 Markdown이 편해요. 후속 재처리까지 생각하면 구조화된 JSON도 같이 보관해 둘 만합니다. 청킹 조건을 바꿀 때 추출 구조를 그대로 다시 쓸 수 있기 때문이에요.
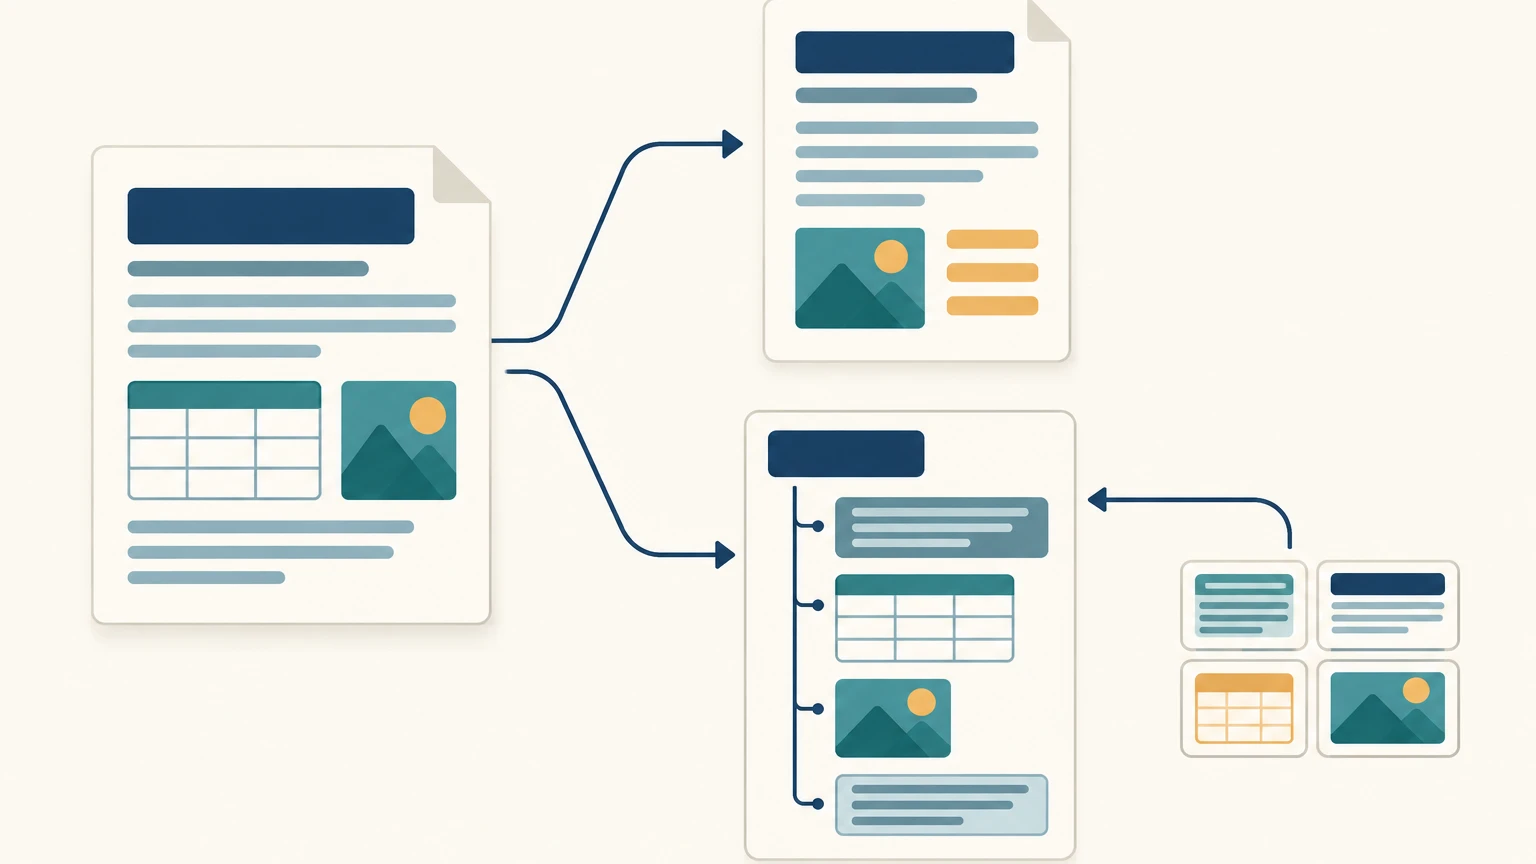
흔히 헷갈리는 지점이 있는데, 구조를 담을 수 있는 능력과 원본에서 구조를 정확히 뽑아내는 능력은 별개입니다.
읽기 순서를 확인할 때도 이 차이를 기억해 두세요. 텍스트 배열만 보지 말고 body 트리와 자식 항목의 순서를 따라가 봐야 합니다. 원본의 읽기 순서가 처음부터 잘못 추출됐다면 그 오류는 JSON에도 그대로 저장돼요.
변환 결과부터 확인하고 HybridChunker로 입력 만들기
설치한 뒤에는 Markdown과 문서 트리를 원본과 나란히 놓고 대조합니다.
pip install doclingfrom docling.document_converter import DocumentConverter
doc = DocumentConverter().convert(source).document
print(doc.export_to_markdown())
print(doc.body)source에는 문서 경로를 넣습니다. body를 볼 때는 자식 항목이 참조하는 실제 내용까지 열어 보세요. 먼저 볼 것은 세 가지입니다. 제목과 본문이 맞게 연결됐는지, 다단 본문이 섞이지 않았는지, 표의 열과 헤더가 유지됐는지를 확인하세요. 이 단계에서 문제가 보이면 청킹으로 넘어가도 해결되지 않으니 여기서 먼저 걸러 내는 편이 낫습니다.
구조에 문제가 없으면 청킹으로 넘어갑니다. 쓰려는 임베딩 모델에 맞춰 embedding_tokenizer에는 토크나이저 객체를, max_tokens에는 토큰 예산을 준비해 두세요.
from docling.chunking import HybridChunker
from docling_core.transforms.chunker.tokenizer.huggingface import (
    HuggingFaceTokenizer,
)

tokenizer = HuggingFaceTokenizer(
    tokenizer=embedding_tokenizer,
    max_tokens=max_tokens,
)
chunker = HybridChunker(tokenizer=tokenizer)

for chunk in chunker.chunk(dl_doc=doc):
    text = chunker.contextualize(chunk)
print(tokenizer.count_tokens(text), text)HybridChunker는 문서 요소와 제목 맥락을 바탕으로 청크를 나누고 여기에 토큰 길이를 반영합니다. 너무 큰 청크는 분할하고, 조건에 맞는 작은 이웃 청크는 합치는 방식이에요. 임베딩 유사도로 경계를 찾는 방식과는 다르니 둘을 구분해 두면 좋습니다. 세부 설정은 공식 청킹 예제를 참고하세요.
chunk.text와 contextualize(chunk)도 자주 헷갈립니다. 앞의 것은 본문이고, 뒤의 것은 본문에 제목 같은 맥락을 덧붙인 문자열이에요.
chunk.text:
JSON도 함께 보관합니다.

contextualize(chunk):
문서 보관
JSON도 함께 보관합니다.
임베딩 입력과 길이 확인에는 맥락이 포함된 문자열을 쓰세요. 청커와 임베딩 모델의 토크나이저도 서로 맞춰야 제목이 붙은 입력 길이를 같은 기준으로 판단할 수 있습니다.
제목 깊이가 틀리거나 표가 깨질 때는 어느 단계 문제인지부터
PDF에서 제목 블록을 감지하는 일과 제목 사이의 상하 관계를 복원하는 일은 별개입니다. 기본 레이아웃 인식은 제목을 찾더라도 깊이까지 정하지는 않아요. 계층 복원은 PDF 파이프라인의 heading_hierarchy_options에 HeadingHierarchyOptions(enabled=True)를 설정해 켭니다. 이때 북마크·번호 체계·시각적 스타일이 활용되고, 글꼴 스타일 신호까지 쓰려면 generate_parsed_pages=True도 필요합니다. 적용 방법은 제목 계층 공식 문서에서 확인하세요.
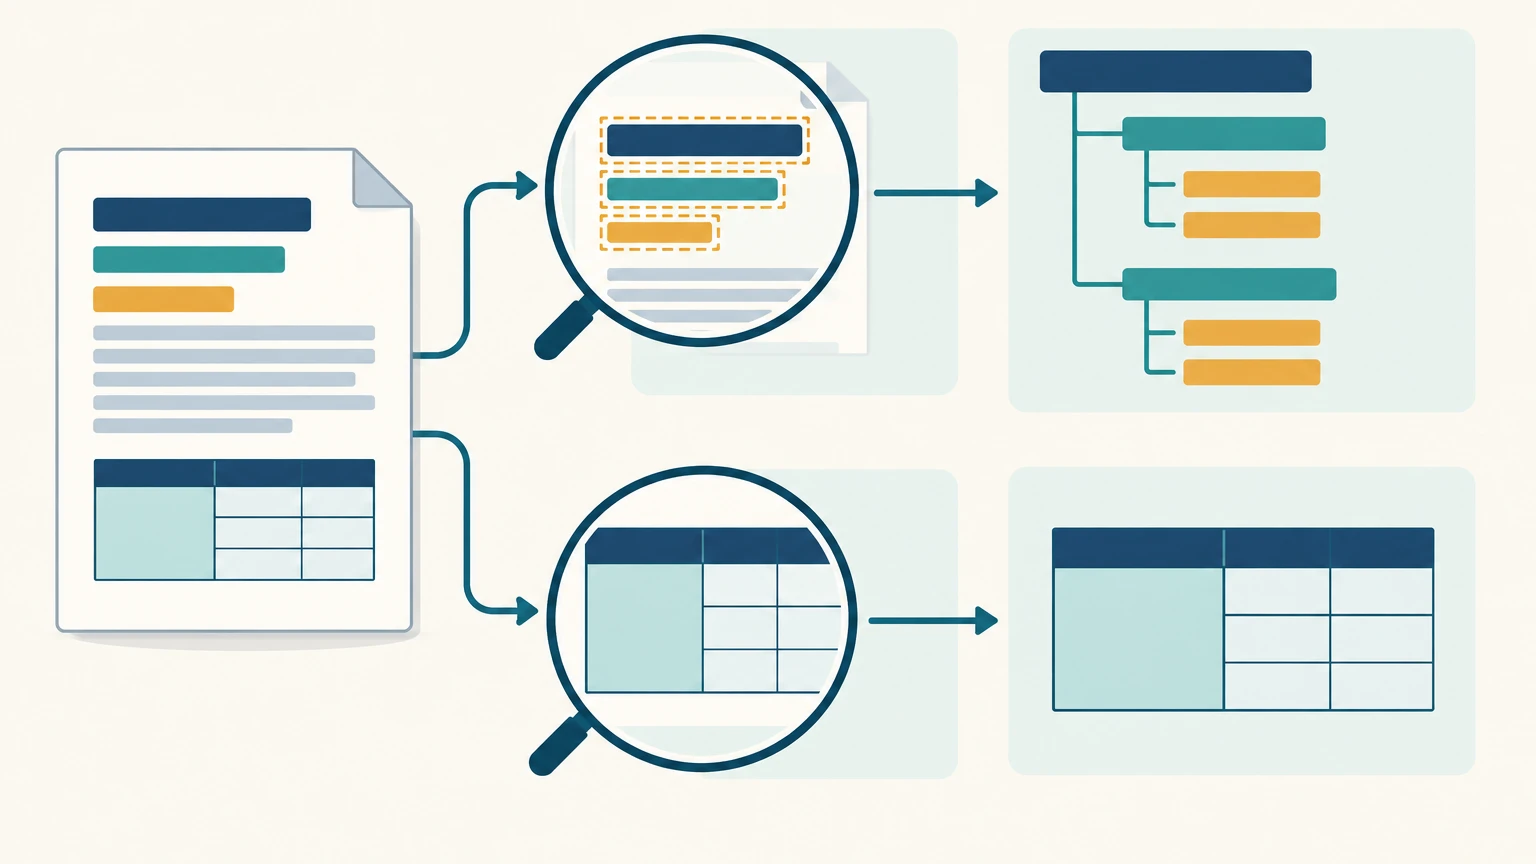
표 문제는 증상을 보고 어느 단계에서 생겼는지부터 가려야 합니다. 여러 열이 하나로 잘못 합쳐졌다면 추출 단계의 문제이니 table_structure_options.do_cell_matching=False를 시도해 볼 수 있어요. 추출은 제대로 됐는데 분할 후 열 이름이 사라졌다면 청킹 쪽 문제이므로 repeat_table_header=True를 확인하세요. 공식 문서상 이 옵션의 기본값은 활성화입니다. 스캔 문서라서 텍스트 추출 자체가 문제라면 OCR 설정도 검토해 볼 수 있어요.
처음에는 제목·다단 본문·표가 함께 들어 있는 작은 PDF로 시작하길 권합니다. 원본과 결과를 나란히 놓고 읽기 순서, 제목 깊이, 분할된 표의 헤더 연결을 대조해 보세요. 기능별 지원 여부는 설치한 버전의 공식 문서에서 확인하고, 변환 결과를 검토한 다음에 처리 대상을 넓히는 편이 좋습니다.
자주 묻는 질문
- Docling의 JSON에 구조가 있으면 읽기 순서도 정확한가요?
- 원본의 읽기 순서가 잘못 추출되면 JSON에도 오류가 저장됩니다. body 트리와 자식 항목의 순서를 따라 실제 내용이 연결되는지 원본과 대조해야 합니다.
- chunk.text와 contextualize(chunk)는 어떻게 다른가요?
- chunk.text는 본문이고, contextualize(chunk)는 제목 같은 맥락을 덧붙인 문자열입니다. 임베딩 입력과 길이 확인에는 맥락을 포함한 문자열을 사용합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.