Gemini 4 Argon API 입문: 첫 호출부터 토큰 한도와 비용까지
Gemini 4 Argon API의 결제·API 키 준비부터 Python 첫 호출, 컨텍스트와 출력 한도까지 정리합니다. 기존 생성 설정을 옮길 때의 차이와 추론·캐시 사용량을 반영한 비용 확인 방법도 살펴봅니다.
Hyuk · · 4분 · AI
핵심 요약
- Gemini 4 Argon API를 사용하려면 유료 결제를 연결한 프로젝트의 API 키가 필요합니다.
- 총 컨텍스트 1,048,576토큰은 입력·추론·최종 출력이 공유하며, 출력 한도에도 추론 토큰이 포함됩니다.
- 65,536토큰을 초과해 생성하려면 더 큰 출력 한도와 백그라운드 실행·저장 설정이 필요합니다.
- 비용은 답변 길이만으로 판단하지 말고 추론과 캐시 적중량을 포함한 실제 사용량으로 확인하세요.
Gemini 4 Argon API를 쓰려면 유료 결제가 연결된 프로젝트의 API 키를 준비하고, Python SDK로 gemini-4-argon을 호출하면 됩니다. 이 모델은 Free tier 대상에서 빠져 있어서 키만 발급받아서는 안 되고, 결제 연결까지 함께 마쳐야 해요. 출력 한도와 비용을 따질 때도 화면에 보이는 답변만 세면 계산이 틀립니다. 추론 토큰도 같이 들어가기 때문이에요.
첫 실습은 짧은 텍스트 요청 하나로 시작하길 권합니다. 인증부터 응답 확인까지 한 번 끝내 두면, 나중에 긴 응답을 다루다 문제가 생겼을 때 어디서 생긴 문제인지 가려내기가 훨씬 쉬워져요.
컨텍스트 한도와 출력 한도는 따로 봐야 합니다
처음 보면 헷갈리기 쉬운 부분이라 먼저 짚고 넘어갈게요. 총 컨텍스트는 1,048,576토큰이고, 입력·추론·최종 출력이 이 공간을 나눠 씁니다. 입력을 끝까지 채운 다음 그만한 크기의 답변을 따로 더 받을 수 있는 구조가 아닙니다. 그래서 입력이 길어질수록 추론과 답변에 남겨 둘 공간이 얼마인지도 함께 살펴야 해요.
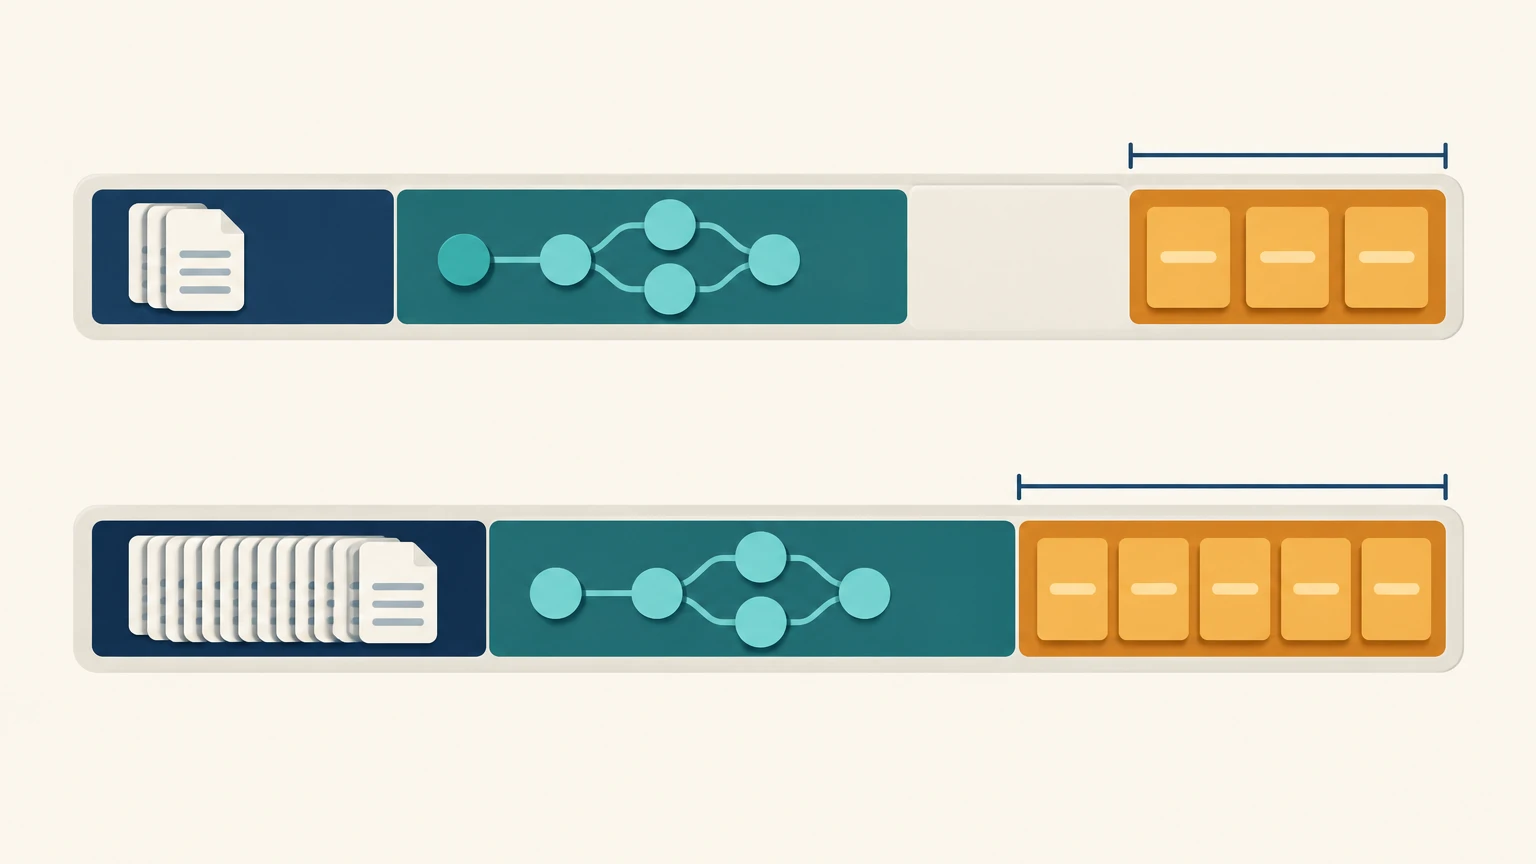
기본 출력 한도는 65,536토큰입니다. max_output_tokens는 추론과 최종 답변을 합친 양을 제한하기 때문에, 이 값을 너무 낮게 잡으면 답변이 중간에 끊길 수 있어요. 프롬프트로 답변 길이를 요청하는 일과 설정으로 생성량 자체를 막는 일은 서로 다른 장치이니 섞어서 생각하지 않는 편이 좋습니다. 구체적인 한도와 긴 생성 조건은 Long decode 공식 문서에서 확인할 수 있어요.
입력으로는 텍스트·이미지·영상·오디오·PDF를 받고 출력은 텍스트로 나오며, 이미지·오디오 생성과 Live API는 지원하지 않습니다.
Python으로 첫 요청 보내기
준비는 아래 순서대로 진행하면 됩니다.
- Google AI Studio에서 프로젝트와 API 키를 준비하고,
Set up billing에서 Cloud Billing을 연결합니다. - 실행 환경에
GEMINI_API_KEY를 등록합니다. pip install -U google-genai로 Python SDK를 설치합니다.
Bash에서는 이렇게 실행하세요. 키 자리에는 발급받은 값을 넣습니다.
export GEMINI_API_KEY="YOUR_API_KEY"
pip install -U google-genai
첫 요청은 Argon 공식 시작 예제의 호출 구조를 그대로 따르되, 입력으로는 작은 함수의 경계 조건을 검토해 달라는 내용을 넣었습니다.
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="""다음 함수의 경계 조건과 수정 방향을
한국어로 짧게 설명해 주세요.

def average(values):
    return sum(values) / len(values)
""",
)

print(interaction.output_text)
print(interaction.usage)genai.Client()는 환경변수에 등록한 키를 읽어 오고, 실제 요청은 client.interactions.create()가 보냅니다. 실행이 끝나면 interaction.output_text를 읽으면서 빈 입력 같은 경계 조건을 제대로 다루는지 확인해 보세요. 저는 여기서 interaction.usage도 꼭 같이 보라고 권하고 싶어요. 화면에 보이는 답변 길이와 실제 처리량이 얼마나 차이 나는지 첫 호출에서부터 감을 잡을 수 있거든요.
기존 코드를 옮길 때, 그리고 긴 응답을 받을 때
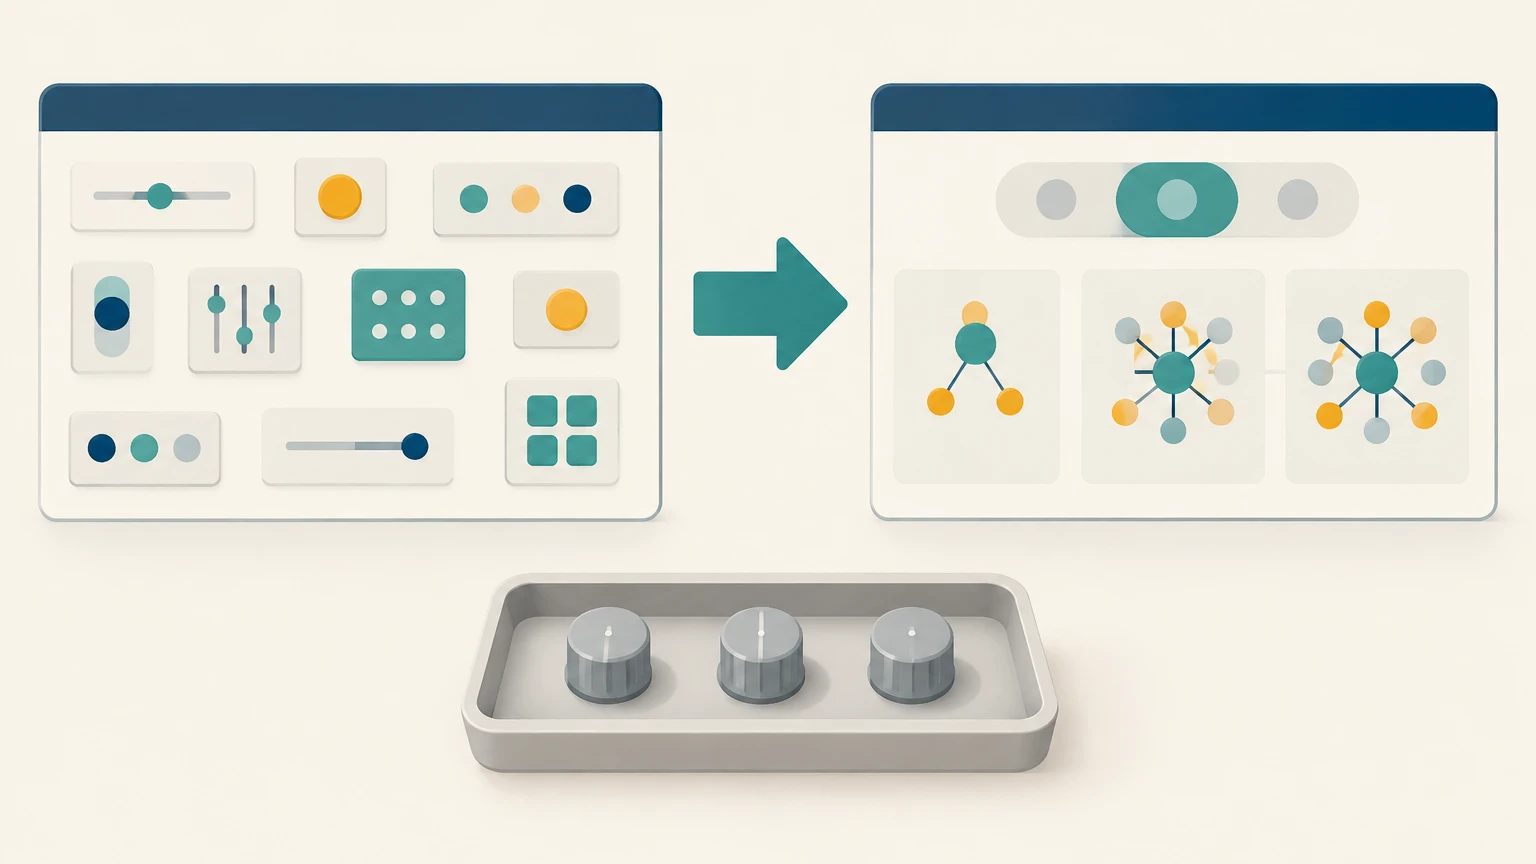
다른 모델을 쓰던 코드를 옮겨 온다면 모델명을 바꾼 다음 생성 설정부터 살펴보세요. thinking_level은 low, medium, high를 지원하고 기본값은 medium입니다. 기존에 쓰던 temperature, top_p, top_k는 넘겨도 무시되니, 남겨 두기보다 지우는 쪽이 코드를 읽을 때 덜 헷갈려요. 캐시 객체를 직접 만드는 명시적 캐싱도 지원하지 않습니다.
65,536토큰을 넘겨 생성하려면 그보다 큰 max_output_tokens를 주고, 여기에 background: true, store: true를 함께 설정해야 합니다. Python에서는 불리언 값을 True로 적어요. 이 방식은 완료 상태를 확인한 뒤 여러 model_output 단계의 텍스트를 이어 붙여 읽어야 해서 손이 꽤 갑니다. 그러니 첫 호출이 문제없이 돌아가는 걸 확인한 다음에 확장하는 순서가 맞다고 봅니다.
비용은 화면이 아니라 usage로 계산하세요
공식 요금표에 나온 Standard 요금은 아래 표와 같고, 모두 100만 토큰당 미국 달러 기준입니다.
| 구분 | 2026-11-30까지 | 2026-12-01부터 |
|---|---|---|
| 입력 | US$2 | US$4 |
| 캐시 적중 입력 | US$0.10 | US$0.20 |
| 출력·추론 | US$10 | US$20 |
비용을 읽을 때는 눈에 보이는 답변보다 usage를 먼저 확인하세요. 출력 과금에는 추론이 포함됩니다. 긴 생성에서 흔히 오해하는 지점도 하나 있어요. 긴 생성의 total_input_tokens는 각 생성 단계의 입력을 모두 더한 값이라, 이 누적 입력량을 현재 컨텍스트 크기로 읽으면 안 됩니다.
캐싱도 생각보다 할인이 덜 적용될 수 있습니다. 암묵적 캐싱이 동작하는 최소 입력 길이는 4,096토큰이고, 실제로 얼마나 적중했는지는 usage.total_cached_tokens로 확인해요. 연속 요청에서 새로 추가된 토큰이 2,050개 미만이면, 이전 요청의 마지막 2,050토큰은 일반 입력 요금으로 다시 처리됩니다. 반복 요청이라고 해서 전체 입력에 캐시 할인 단가를 매겨 계산하지 말고, 실제 적중량과 누적 사용량을 나란히 놓고 읽는 습관을 들이세요.
자주 묻는 질문
- 짧은 답변을 원하면 max_output_tokens를 낮추면 되나요?
- `max_output_tokens`는 추론과 최종 답변을 합쳐 제한하므로 지나치게 낮추면 답변이 중간에 끊길 수 있습니다. 프롬프트에서 답변 길이를 요청하는 것과 생성량 제한은 구분해서 다루세요.
- 기존 temperature 설정을 그대로 사용할 수 있나요?
- `temperature`, `top_p`, `top_k`는 전달해도 무시됩니다. `thinking_level`은 `low`, `medium`, `high`를 지원하며 기본값은 `medium`입니다.
- 같은 입력을 반복하면 전체 입력에 캐시 할인이 적용되나요?
- 전체 입력에 할인 단가를 적용하지 말고 `usage.total_cached_tokens`로 실제 적중량을 확인해야 합니다. 연속 요청에서 추가된 토큰이 2,050개 미만이면 이전 요청의 마지막 2,050토큰을 일반 입력 요금으로 다시 처리합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.