GPT-6 Pro 병렬 에이전트, 기능 구분과 도입 전 확인할 점
GPT-6 Pro 병렬 에이전트를 검토할 때 구분해야 할 Pro 실행 모드와 멀티 에이전트 설정, API별 지원 조건을 정리합니다. 독립 작업의 분담부터 결과 통합까지 성능과 비용을 비교하는 기준도 안내합니다.
Hyuk · · 4분 · AI
핵심 요약
- Pro는 추론 실행 모드이며, 선택만으로 병렬 에이전트가 자동 실행된다고 볼 수는 없습니다.
- 멀티 에이전트 지원 여부는 정확한 모델과 API 조합, 베타 조건, 계정 접근권을 함께 확인해야 합니다.
- 병렬 실행의 효과는 최종 결과를 통합하는 시간과 총토큰·비용, 수정 부담까지 포함해 비교해야 합니다.
- Agents API의 하위 에이전트는 각자의 문맥에서 작업하지만 실행 환경의 파일 시스템을 공유합니다.
GPT-6 Pro 병렬 에이전트를 쓰려면 먼저 Pro 모드와 병렬 에이전트 설정이 서로 다른 기능이라는 점을 알아야 합니다. Pro는 추론을 실행하는 모드예요. 병렬 에이전트는 주 에이전트가 하위 에이전트에게 작업을 나눠 맡기도록 따로 켜는 기능입니다. 그래서 Pro를 고른다고 병렬 에이전트가 자동으로 돌아간다고 보기는 어려워요. 'GPT-6 Pro 병렬 에이전트'가 하나의 공식 기능명인지도 아직 확인이 필요합니다.
'GPT-6 Pro'는 모델 이름일까요, 실행 모드일까요
가장 많이 헷갈리는 부분이라 여기부터 정리하는 게 좋습니다. 모델명과 구독 요금제, 실행 모드를 하나씩 떼어 보세요. 공식 모델 목록에 나오는 이름은 GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna이고, 'GPT-6 Pro'를 독립된 모델명으로 읽을 근거는 부족해요. 같은 'Pro'라도 구독 상품의 Pro와 API 설정의 Pro는 서로 다른 것을 가리킵니다.
Responses API에서 Pro 모드는 reasoning.mode: "pro"로 선택해요. 추론 노력 수준을 정하는 reasoning.effort와는 별개로 설정하는 값입니다. 비용은 따로 짚어 둘 필요가 있습니다. 추가 모델 작업에 쓴 토큰까지 합산되기 때문에 표준 토큰 단가가 같더라도 총비용은 늘어날 수 있어요. 설정 방법과 과금 방식은 공식 추론 문서에 나와 있습니다.
어떤 모델이 지원되고, 동시에 몇 개까지 돌까요
지원 여부를 볼 때는 모델 계열보다 쓰려는 API와 정확한 모델 조합을 먼저 확인하길 권해요. Responses API의 멀티 에이전트 전용 문서는 베타 지원 대상으로 GPT-6.1 Sol과 모든 GPT-5.6 모델을 명시합니다. 활성화에는 multi_agent.enabled와 responses_multi_agent=v1 베타 설정을 씁니다. 이 내용을 GPT-6 계열 전체가 지원된다는 뜻으로 넓혀 읽으면 적용 조건을 놓치기 쉬워요. 다른 API 예제에 나온 모델이라도 Responses API에서 같은 조합이 지원되는지는 따로 봐야 합니다.
동시 실행 기본값도 API마다 달라요. Responses API의 max_concurrent_subagents는 주 에이전트를 빼고 3개, Agents API는 조정 에이전트를 빼고 6개입니다. 둘 다 각 API의 기본 설정값일 뿐이라 GPT-6 전체에 공통으로 적용되는 최대 에이전트 수로 받아들이면 곤란합니다. Responses API를 도입하려면 멀티 에이전트 전용 문서에서 지원 모델과 베타 조건을 함께 확인하는 일부터 하세요.
ChatGPT Work의 Ultra는 병렬 작업이 속도나 품질에 도움이 될 때 자동으로 위임할 수 있는 지능 수준으로 안내되며, API의 Pro 실행 모드와는 구별해야 합니다.
처음엔 서로 기다리지 않는 작업으로 시험해 보세요
첫 실험으로는 각자 결과를 기다리지 않고 진행할 수 있는 검토 작업이 잘 맞습니다. 코드 검토를 보안, 테스트 누락, 유지보수성으로 나눈다고 해 볼게요. 보안 담당에게는 위험 지점과 그 근거를 요청합니다. 테스트 담당에게는 검증되지 않은 동작과 필요한 테스트를, 유지보수성 담당에게는 바꾸기 어려운 구조와 개선 이유를 요청하고요. 담당별로 산출물을 구체적으로 정해 두면 나중에 결과를 합칠 때 빠진 근거가 금방 드러나요.
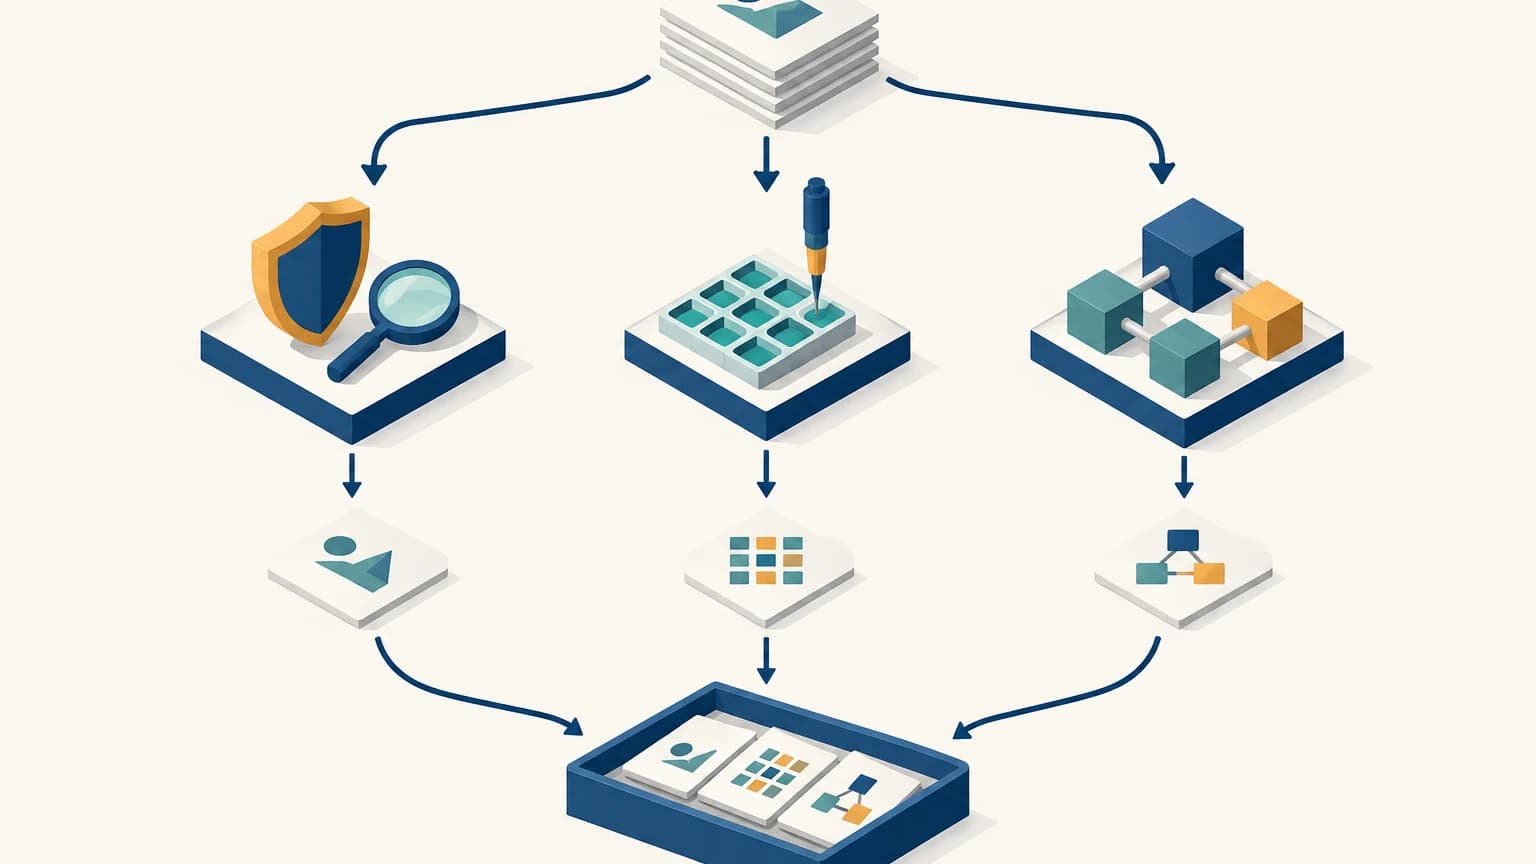
통합 단계는 따로 설계해 두는 편이 좋습니다. 같은 코드와 같은 원인을 지적한 의견은 하나로 묶고, 판단이 엇갈리면 원본 코드와 테스트 근거를 다시 대조하게 하세요. 이때 몇 개의 에이전트가 같은 말을 했는지보다 각 주장의 근거를 먼저 봐야 해요. 하위 에이전트 작업이 끝난 뒤에도 통합에 시간이 걸리니, 완료 시간은 최종 결과가 정리되는 시점까지로 잡아야 합니다.
단일 실행과 병렬 실행은 모델, 추론 노력 수준, 작업을 똑같이 맞춘 상태에서 비교하세요. 기록할 항목은 전체 완료 시간, 총토큰과 비용, 근거 누락, 최종 결과의 수정 필요량이에요. 속도가 빨라져도 검토와 수정 부담이 커졌다면 도입 효과는 다시 따져 봐야 합니다.
Pro의 효과는 따로 비교해야 병렬화의 효과와 섞이지 않습니다.
적용하기 전에 접근권과 파일 공간을 확인하세요
실험 전에 확인할 것은 두 가지예요. 해당 모델과 API에서 Pro와 멀티 에이전트를 함께 쓸 수 있는지, 그리고 계정에 필요한 접근권이 있는지입니다. 모델을 쓸 수 있다고 해서 Ultra나 하위 에이전트까지 이용할 수 있다고 판단하기는 어려워요.
Agents API 문서에 따르면 하위 에이전트는 각자의 문맥에서 일하지만, 조정 에이전트와 실행 환경의 파일 시스템은 공유합니다. 문맥이 따로라고 파일 공간까지 따로인 건 아니라는 점이 여기서 흔히 놓치는 부분이에요. 여러 에이전트가 같은 파일을 고칠 수 있다면 담당 범위와 변경을 합치는 순서를 미리 정해 두세요.
지원 정보는 2026년 10월 26일 기준 공식 문서를 따랐고, 문서상 안내와 실제 계정의 호출 결과는 구분해서 봐야 합니다. 일정한 배수의 속도 향상이 확인된 것은 아니니 실제 작업으로 시간을 재 보는 게 맞습니다. 적용 직전에 지원 모델, 베타 설정, 계정별 제공 조건을 다시 확인하고, 도입 여부는 실제 호출 결과와 통합 비용까지 본 뒤에 정하길 권해요.
자주 묻는 질문
- Responses API에서 병렬 에이전트는 기본적으로 몇 개까지 동시에 실행되나요?
- `max_concurrent_subagents` 기본값은 주 에이전트를 제외한 3개입니다. 이는 해당 API의 기본 설정값이며 GPT-6 전체에 공통인 최대 에이전트 수를 뜻하지는 않습니다.
- Pro 모드는 추론 노력 수준과 따로 설정할 수 있나요?
- Responses API에서는 `reasoning.mode: "pro"`를 추론 노력 수준인 `reasoning.effort`와 독립적으로 설정합니다.
- 병렬 에이전트가 같은 파일을 수정해도 되나요?
- Agents API에서는 하위 에이전트가 조정 에이전트와 파일 시스템을 공유하므로, 같은 파일을 수정한다면 담당 범위와 변경 통합 순서를 정하는 편이 좋습니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.