MiniCPM-V 4.7 온디바이스 AI: 3GB 실행의 의미와 실사용 검증법
MiniCPM-V 4.7의 스마트폰 실행 발표에서 3GB 메모리와 초당 13토큰 이상이 뜻하는 범위를 짚습니다. MoE·LES 구조와 함께 1B부터 한국어 문서 정확도, 대기시간, 반복 사용 부담을 비교하는 순서를 정리합니다.
Hyuk · · 4분 · AI
핵심 요약
- 발표된 실행 메모리 3GB는 전체 모델 파일의 저장 용량과 구분해야 합니다.
- 초당 13토큰 이상은 디코딩 속도이므로 문서 이해 정확도와 첫 토큰 대기시간도 함께 확인해야 합니다.
- 모바일 용도는 1B부터 시험하고, 목표 정확도에 미치지 못하면 같은 입력과 측정 기준으로 35B-A3B를 비교하는 순서를 권합니다.
MiniCPM-V 4.7의 35B-A3B는 개발팀 발표에 따르면 스마트폰에서 실행할 수 있습니다. 공개된 수치는 iPhone 17 Pro Max에서 실행 메모리 3GB로 초당 13토큰 이상을 생성한다는 내용이에요. 여기서 3GB는 전체 모델 파일의 저장 용량과 다른 값이라, 기기에 필요한 저장 공간은 따로 확인하셔야 합니다.
초당 13토큰 이상이라는 숫자는 답변을 생성하는 디코딩 단계의 속도입니다. 이미지를 처리하고 첫 답변이 나오기까지 걸리는 시간이 모두 들어간 값은 아니에요. 그래서 실사용 여부를 가늠할 때는 생성 속도보다 문서 이해 정확도와 첫 토큰 대기시간을 먼저 보시길 권합니다. 발표 범위는 35B-A3B 공식 모델 카드에서 확인할 수 있어요.
모델이 돌아간다는 것과 업무에 쓸 만한 답을 제때 받는다는 것은 따로 평가해야 하는 문제입니다.
35B 모델이 어떻게 3GB 메모리로 돌아갈까
35B-A3B의 전체 파라미터는 약 352억 개이고, 활성 파라미터는 약 35억 개예요. 이 차이는 MoE 구조에서 나옵니다. MoE는 여러 전문가 가운데 토큰마다 선택된 일부만 계산에 쓰는 방식인데, 한 번에 전체 가중치를 쓰지 않더라도 다음 토큰에서는 다른 전문가가 뽑힐 수 있어요. 그러니 활성 파라미터가 적다고 해서 전체 모델의 저장 공간까지 같은 비율로 줄어드는 건 아닙니다.
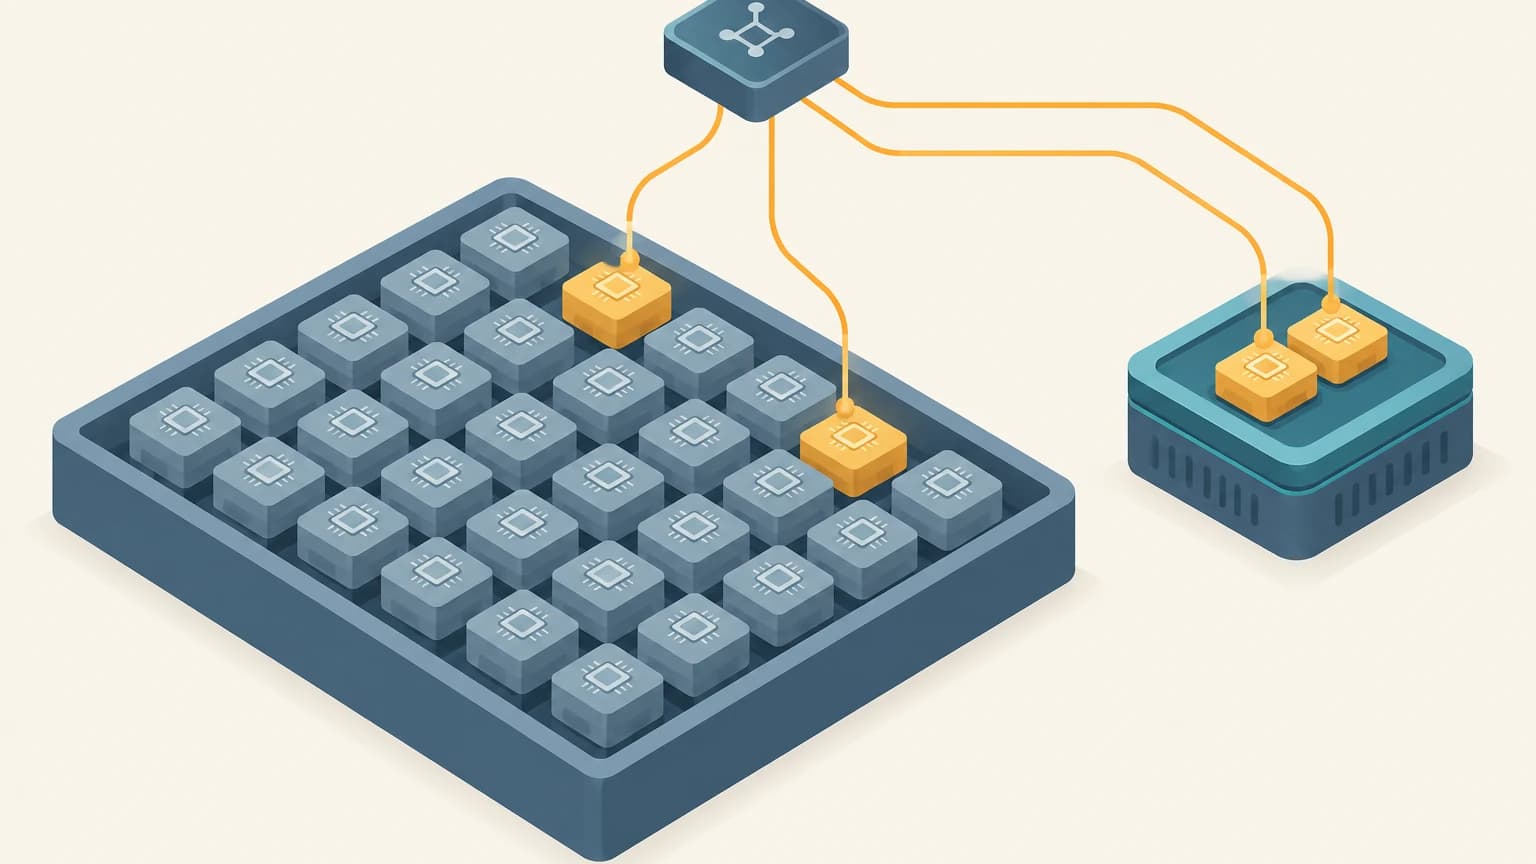
LES는 다음 층에서 쓸 전문가를 예측해 미리 불러오고, 가중치 로딩과 계산을 겹쳐서 진행합니다. 예측에서 빠진 전문가라도 실제 라우터가 선택했다면 불러와서 계산해요. 이 때문에 실행 메모리만 볼 게 아니라 저장장치에서 가중치를 가져오는 과정까지 함께 봐야 합니다.
이 대목에서 가장 많이 섞이는 게 세 가지 지표예요. 저장 파일 크기는 기기에 보관할 모델의 용량이고, 실행 메모리는 추론하는 동안 쓰는 메모리, 생성 속도는 답변 토큰이 만들어지는 빠르기를 말합니다. 하나가 작거나 빠르다고 해서 나머지까지 짐작할 수는 없으니, 수치를 볼 때마다 어느 지표인지부터 확인하는 습관을 들이시면 좋겠습니다.
LES가 필요한 전문가를 생략하지 않는다는 설명과, 양자화한 모델의 정확도가 모든 작업에서 유지된다는 주장은 별개의 이야기입니다. 특히 한국어 문서의 세부 내용을 얼마나 정확히 읽는지는 실제 입력으로 비교해 봐야 알 수 있어요.
1B부터 같은 한국어 문서로 비교해 보기
모바일 용도라면 공식적으로 모바일·초경량 배포용으로 안내된 1B부터 시험해 보는 순서를 권합니다. 1B로 목표 정확도에 닿지 못할 때 35B-A3B와 비교하면, 더 큰 모델이 왜 필요한지가 분명해지거든요. 이름은 1B지만 실제 규모는 약 15억 5천만 파라미터라서, 이름만 보고 자원 사용량을 추정하지 않는 편이 안전합니다.
시각 입력 설정도 같이 비교해야 해요. 4배 압축인 downsample_mode="4x"는 "16x"보다 시각 토큰을 네 배 유지하기 때문에 세부 정보가 더 많이 남습니다. 작은 글씨가 있는 문서라면 이 설정부터 비교해 볼 만합니다. 다만 압축 배율이 곧 전체 응답 속도의 향상 배율이라고 읽으면 곤란해요. 설정의 의미는 1B 공식 모델 카드를 참고하시면 됩니다.
검증은 이런 순서로 진행할 수 있습니다.
- 기기, 모델 파일, 양자화 방식, 앱 또는 런타임 버전을 고정합니다.
- 같은 한국어 문서 이미지와 질문으로 4배·16배 시각 압축을 각각 시험합니다.
- 원문과 답변을 대조해 추출 정확도를 기록하고, 첫 토큰 대기시간과 전체 완료 시간을 따로 측정합니다.
- 반복 실행하며 최대 메모리, 발열, 배터리 변화를 기록합니다.
35B-A3B와 비교할 때도 입력과 측정 기준은 그대로 두셔야 해요. 필요한 정확도를 충족하는지 먼저 보고, 그다음에 대기시간과 반복 사용 부담을 판단하는 게 제가 권하는 순서입니다. 정확도가 모자란 모델은 아무리 빨라도 쓸 수 없으니까요.
내 기기에 올리기 전에 확인할 조건
공식 앱은 모델 파일을 내려받은 뒤 기기 안에서 추론하는 방식으로 안내돼 있습니다. 앱 설치와 모델 다운로드는 별도 절차이고, 공통 권장 RAM은 6GB 이상이에요. 여기서 흔히 헷갈리는데, 이 권장 사양을 만족한다고 35B-A3B가 해당 기기 모두에서 실행된다고 보기는 어렵습니다. 사용할 모델과 기기의 지원 조건을 함께 확인하셔야 해요.
서로 다른 기기에서 측정한 성능 수치를 나란히 놓고 비교하는 것도 피하는 편이 좋습니다. 같은 모델이라도 양자화, 런타임, LES와 DSpark 적용 여부에 따라 측정 조건이 달라지기 때문이에요. 성능 자료를 인용해 글을 쓰거나 공유할 생각이라면, 공식 문서의 버전·수정 시점과 측정 조건부터 대조해 두시길 권합니다.
개발팀의 스마트폰 실행 발표와는 별개로, 독립적인 동일 조건 재현 결과와 한국어 문서 정확도, 장시간 사용 시 발열·배터리 특성은 아직 추가 확인이 필요한 부분입니다. 결국 도입 여부는 내 기기에서 같은 문서를 반복 처리해 얻은 정확도와 대기시간을 기준으로 판단하는 게 합리적이에요.
자주 묻는 질문
- RAM 6GB인 스마트폰이면 35B-A3B를 실행할 수 있나요?
- 공통 권장 RAM은 6GB 이상이지만, 이 사양만으로 모든 해당 기기에서 35B-A3B가 실행된다고 판단하기는 어렵습니다. 사용할 모델과 기기의 지원 조건을 함께 확인해야 합니다.
- 작은 글씨가 있는 문서는 어떤 시각 압축 설정부터 비교하면 좋나요?
- `downsample_mode="4x"`는 `"16x"`보다 시각 토큰을 네 배 유지해 세부 정보를 더 남기므로 먼저 비교할 만합니다. 같은 문서와 질문으로 추출 정확도와 응답 시간을 각각 측정하는 편이 좋습니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.