Mistral Large 4 실행비용: API 작업당 요금 계산과 자체 서버 견적 기준
Mistral Large 4 실행비용을 API 토큰 요금과 자체 서버 운영비로 나눠 설명합니다. 호출당 비용 계산부터 캐시·배치·추론 설정의 영향, 완료 작업당 비용으로 비교하는 기준까지 정리했습니다.
Hyuk · · 4분 · AI
핵심 요약
- 2026년 11월 6일 기준 표준 API 요금은 100만 토큰당 입력 0.70달러, 캐시 입력 0.07달러, 출력 2.10달러입니다.
- 에이전트 비용은 실패한 시도와 재시도까지 합산한 뒤 완료된 작업 수로 나눠 비교해야 합니다.
- 캐시 입력의 90% 할인은 전체 호출 비용의 절감률과 다르므로 실제 캐시 적중량을 기준으로 계산해야 합니다.
- 자체 서버와 API는 같은 품질·문맥 길이·동시성에서 완료 작업당 비용으로 비교하는 편이 합리적입니다.
Mistral Large 4 실행비용은 2026년 11월 6일 기준 표준 API에서 100만 토큰당 입력 0.70달러, 캐시 입력 0.07달러, 출력 2.10달러입니다. 캐시 없이 입력 1만 토큰과 출력 2천 토큰을 쓰면 호출 한 번에 0.0112달러가 나와요. 자체 서버로 돌릴 계획이라면 이 단가와 별개로 GPU를 포함한 인프라와 운영비를 따로 견적 내야 합니다.
비교는 토큰 단가를 확인한 다음, 완료된 작업 한 건에 드는 비용을 보는 순서로 하길 권합니다. 단가가 같아도 한 번 호출로 끝나는 요약과 여러 호출이 이어지는 에이전트 작업은 최종 비용이 크게 달라지거든요.
호출 한 번의 비용을 작업 한 건의 비용으로 바꾸기
공식 가격표를 기준으로 일반 입력, 캐시 입력, 과금 대상 출력의 비용을 각각 구해 더하면 됩니다. 여기서 많이 헷갈리는 부분이 있어요. 전체 입력에는 캐시로 처리된 분량도 들어 있으니, 일반 입력 단가를 곱하기 전에 캐시 적중량을 먼저 빼야 합니다.
호출 비용(USD)
= [(전체 입력 − 캐시 입력) × 0.70
   + 캐시 입력 × 0.07
   + 과금 대상 출력 × 2.10] ÷ 1,000,000
캐시 없는 입력 1만·출력 2천 토큰이라면 입력 비용 0.007달러, 출력 비용 0.0042달러를 더해 합계 0.0112달러입니다. 같은 사용량으로 1만 번 호출하면 112달러가 되죠. 이 금액은 토큰 요금만 계산한 값이라 세금·환전·외부 도구 비용은 포함되지 않아요.
에이전트는 호출 단위로만 보면 안 됩니다. 요청별 사용량을 기록해 두고, 같은 작업 ID에 속한 호출과 재시도 비용을 모두 합산하세요. 그 전체 비용을 완료된 작업 수로 나눠야 업무 단위로 비교할 수 있습니다. 실패한 시도의 비용도 합계에 꼭 남겨 두는 게 좋아요. 이 비용을 빼면 재시도가 많은 설정이 오히려 저렴해 보이는 착시가 생깁니다.
캐시·배치·추론 모드가 비용을 얼마나 바꾸나
캐시 입력 단가는 일반 입력보다 90% 낮지만, 전체 호출 비용이 그만큼 줄지는 않습니다. 앞의 조건에서 입력 1만 토큰 중 8천 토큰이 캐시에 적중했다고 해 볼게요. 일반 입력은 2천 토큰이 남습니다. 일반 입력 0.0014달러, 캐시 입력 0.00056달러, 출력 0.0042달러를 더하면 0.00616달러이고, 캐시가 없을 때보다 전체 비용이 45% 줄어든 셈이에요.
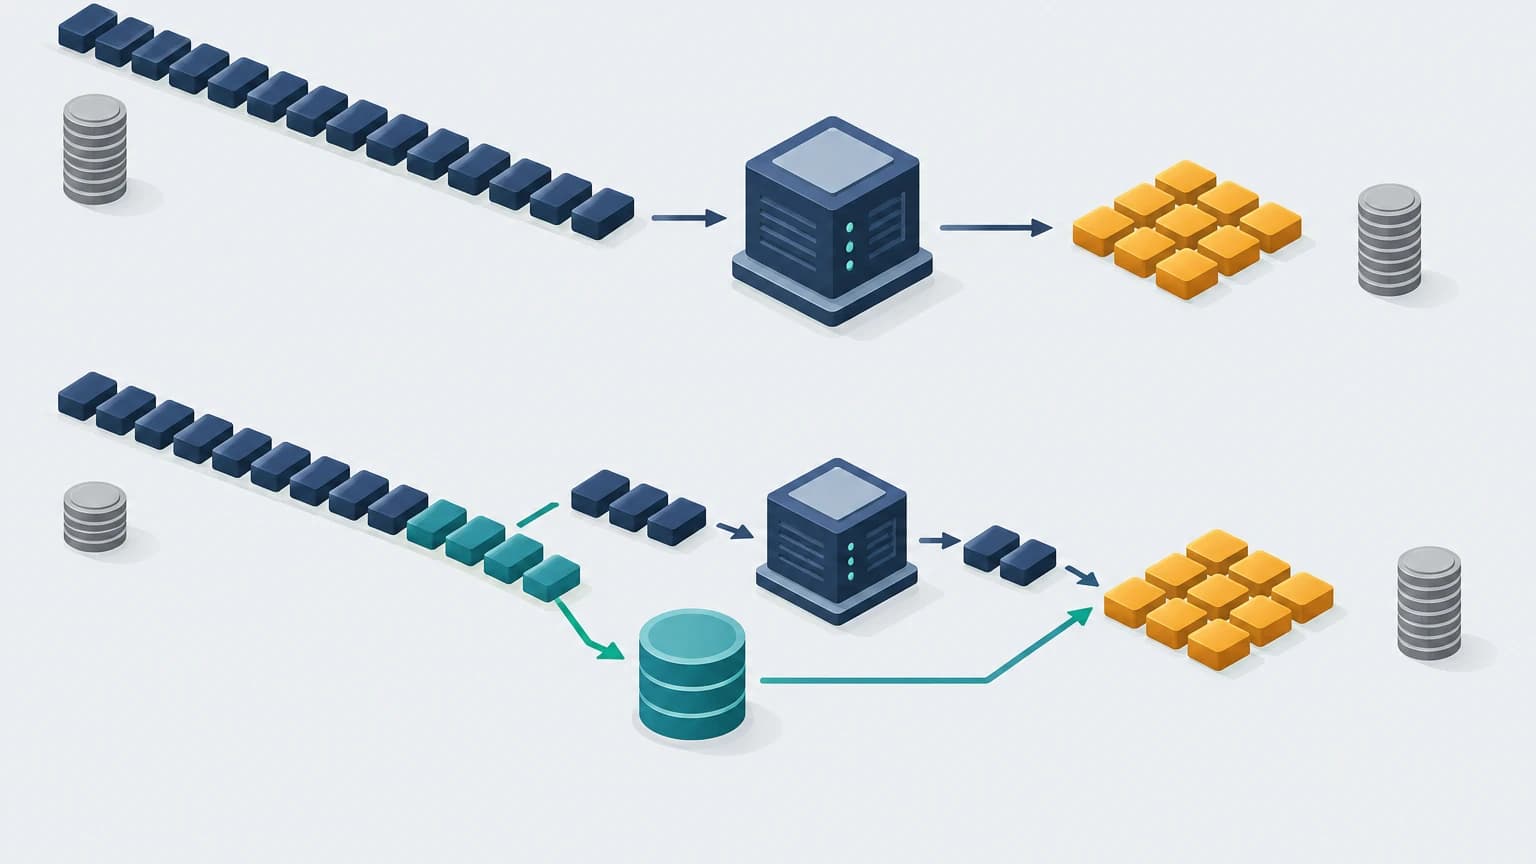
그래서 캐시는 켜 두었는지보다 실제로 얼마나 적중했는지를 먼저 보셔야 합니다.
프롬프트 캐시는 요청 앞부분의 동일한 내용을 재사용하는 방식입니다. 비용을 정확히 계산하려면 응답의 usage.prompt_tokens_details.cached_tokens에 반환된 적중량을 넣어야 하고요. 출력 비중이 큰 작업일수록 입력 할인이 전체 비용에 미치는 영향은 작아진다는 점도 기억해 두세요.
실시간 응답이 필요 없는 작업이라면 배치 처리의 50% 할인도 검토할 만합니다. 그 전에 결과를 비동기로 받아도 괜찮은지부터 판단하는 게 순서예요.
추론 모드는 low, medium, high 세 가지이고 기본값은 high입니다. 같은 작업 집합을 두고 모드별 품질, 전체 생성량, 재시도 횟수를 함께 비교해 보는 편을 권해요. 생성량이 줄어도 재시도가 늘면 완료 작업당 비용은 오히려 오를 수 있기 때문이죠. 모델 카드의 생성 한도에는 추론 토큰과 화면에 보이는 출력 토큰이 모두 포함되므로, 최종 답변 길이만 보고 사용량을 짐작하기는 어렵습니다.
자체 서버로 돌릴 때 견적을 잡는 기준
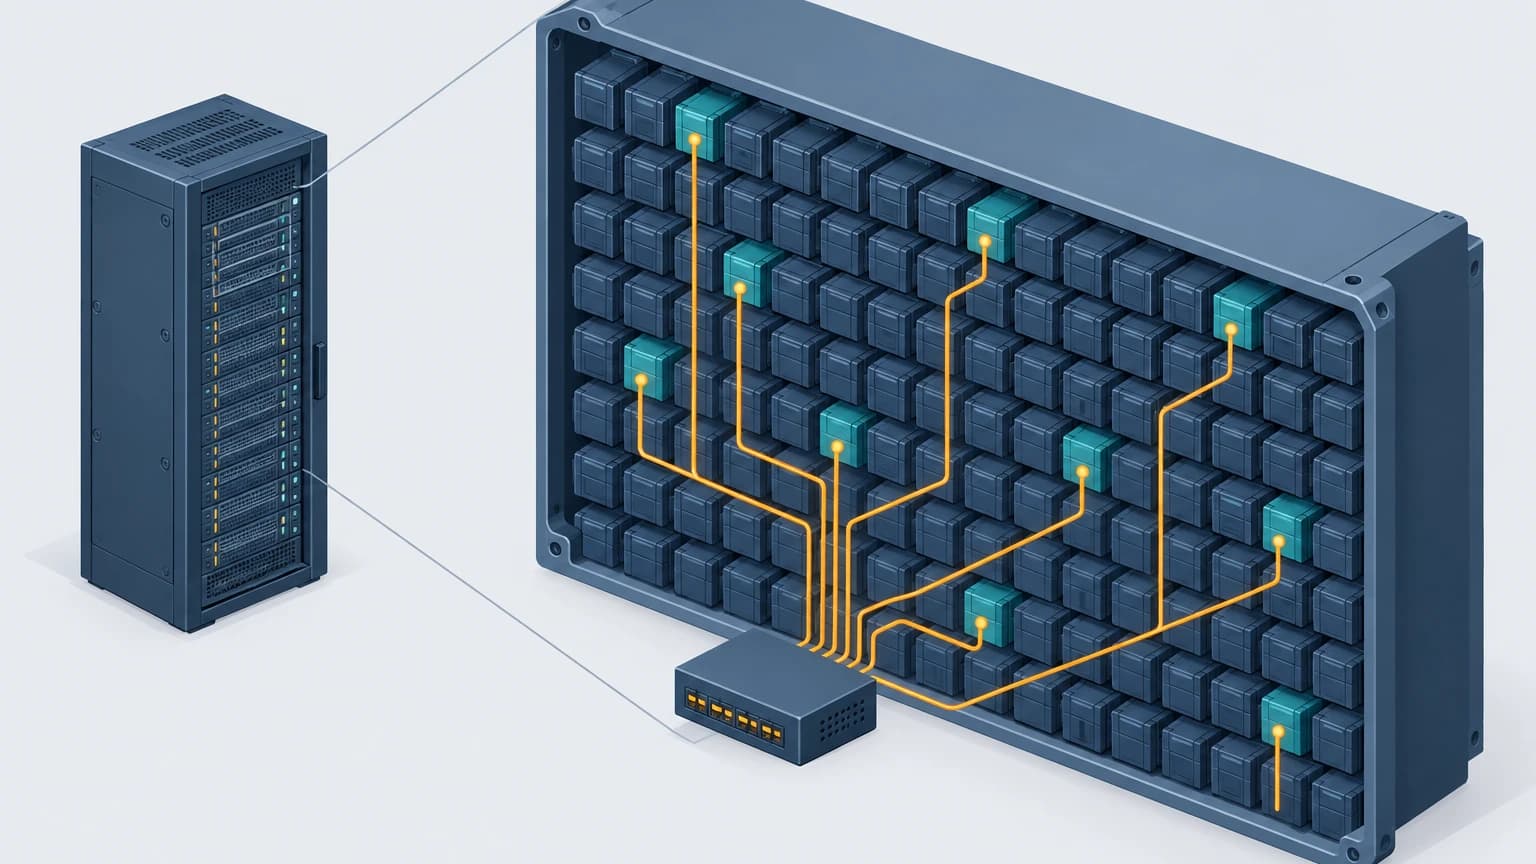
자체 실행 견적에서 가장 먼저 구분할 것은 활성 파라미터 520억 개와 전체 파라미터 1.05조 개입니다. Mistral Large 4는 MoE 구조이고, 활성 파라미터는 한 번의 연산에 참여하는 부분을 말해요. 활성 파라미터 숫자만 보고 전체 가중치 저장 규모를 판단하면 필요한 메모리와 서버 비용을 잘못 잡을 수 있습니다.
공식 모델 카드의 vLLM 예제는 --tensor-parallel-size 8을 씁니다. 하지만 이 설정 하나로 최소 GPU 사양이나 시간당 비용을 확정하긴 어려워요. 메모리 요구량은 문맥 길이와 동시 처리 수에 따라서도 달라지니, 운영 조건을 먼저 정한 뒤 견적을 받는 편이 맞습니다.
비교 기준은 같은 품질·문맥 길이·동시성에서의 완료 작업당 비용으로 잡으세요. 자체 서버는 월 인프라 비용과 운영비를 합쳐 실제 완료 작업 수로 나누고, API도 같은 작업 집합의 총비용으로 계산해야 공정하게 비교할 수 있어요. 처리할 일이 적으면 서버 쪽 작업당 비용 부담이 커지기 때문에, 최대 처리량보다 실제 월간 사용량을 먼저 잡는 편이 합리적입니다.
최종 비교 전에는 API와 자체 실행의 모델 버전이 일치하는지 확인하세요. 프리뷰와 후속 활성 버전의 측정값을 섞으면 안 됩니다. 추론 토큰의 청구 방식, 그리고 캐시와 배치 할인이 중복 적용되는지는 공식 문서에서 확인해야 해요. 라이선스도 빠뜨리지 마세요. Model-as-a-Service 사업에 해당한다면 별도 상업 계약 조건을 비용에 반영할 필요가 있습니다.
자주 묻는 질문
- 입력 1만 토큰과 출력 2천 토큰으로 1만 번 호출하면 얼마인가요?
- 캐시가 없다면 호출당 0.0112달러로, 1만 번 호출할 때 토큰 요금은 112달러입니다. 세금·환전·외부 도구 비용은 제외한 금액입니다.
- 캐시에 적중한 입력 토큰 수는 어디서 확인하나요?
- 응답의 `usage.prompt_tokens_details.cached_tokens`에서 확인합니다. 일반 입력 비용을 계산할 때는 전체 입력 토큰에서 이 값을 빼야 합니다.
- vLLM 예제만으로 자체 실행에 필요한 GPU 비용을 알 수 있나요?
- `--tensor-parallel-size 8` 설정만으로 최소 GPU 사양이나 시간당 비용을 확정하기는 어렵습니다. 문맥 길이와 동시 처리 수 등 운영 조건을 정한 뒤 견적을 받아야 합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.