PostgreSQL 하이브리드 검색: BM25·벡터 검색을 RRF로 결합하는 강좌 활용법
PostgreSQL 하이브리드 검색에서 BM25와 벡터 검색의 후보를 RRF로 결합하는 흐름을 설명합니다. 검색 대상 범위와 확장 구성, 정렬 방향, 질의·필터별 품질 및 성능 검증 기준을 정리합니다.
Hyuk · · 4분 · AI
핵심 요약
- BM25와 벡터 검색의 결합 효과는 임베딩이 있는 동일한 문서 집합에서 비교하는 편이 좋습니다.
- RRF는 검색 점수가 아닌 순위를 결합하므로 가중치 조절에 앞서 관련 문서가 후보에 포함되는지 확인해야 합니다.
- 검색 품질과 실행 시간은 별도로 평가하고, 필터를 적용했다면 반환된 문서 수도 확인해야 합니다.
PostgreSQL 하이브리드 검색은 두 갈래로 후보를 찾은 뒤 하나로 합치는 방식이에요. BM25가 어휘가 일치하는 문서를, 벡터 검색이 의미가 유사한 문서를 각각 찾아내면 RRF가 두 결과의 순위를 합쳐 최종 목록을 만듭니다. 이 강좌는 Simple English Wikipedia 검색 앱을 만들면서 후보 추출부터 순위 결합까지 직접 구현해요. 따라가실 때는 각 검색기가 어떤 문서를 찾았는지부터 비교하고, 결합한 뒤 관련 문서가 실제로 위로 올라오는지 확인해 보시길 권합니다.
질의를 고를 때 두 종류를 섞어 보면 차이가 잘 보입니다. Apollo 13처럼 명칭이 분명한 질의는 어휘 일치가 어떻게 작동하는지 살펴보기 좋아요. 반대로 ‘스스로 빛을 내는 동물’처럼 개념을 풀어 쓴 질의를 넣으면, 표현이 달라도 뜻이 통하는 문서를 찾아내는 의미 검색의 역할이 드러납니다. 어느 검색기가 더 유용한지는 미리 정해 두기보다 실제 후보와 순위를 보고 판단하는 편이 맞습니다.
가중치를 만지기 전에 검색 대상과 확장부터 맞춰 보세요
가장 먼저 볼 것은 두 검색기가 뒤지는 문서의 범위가 같은지예요.
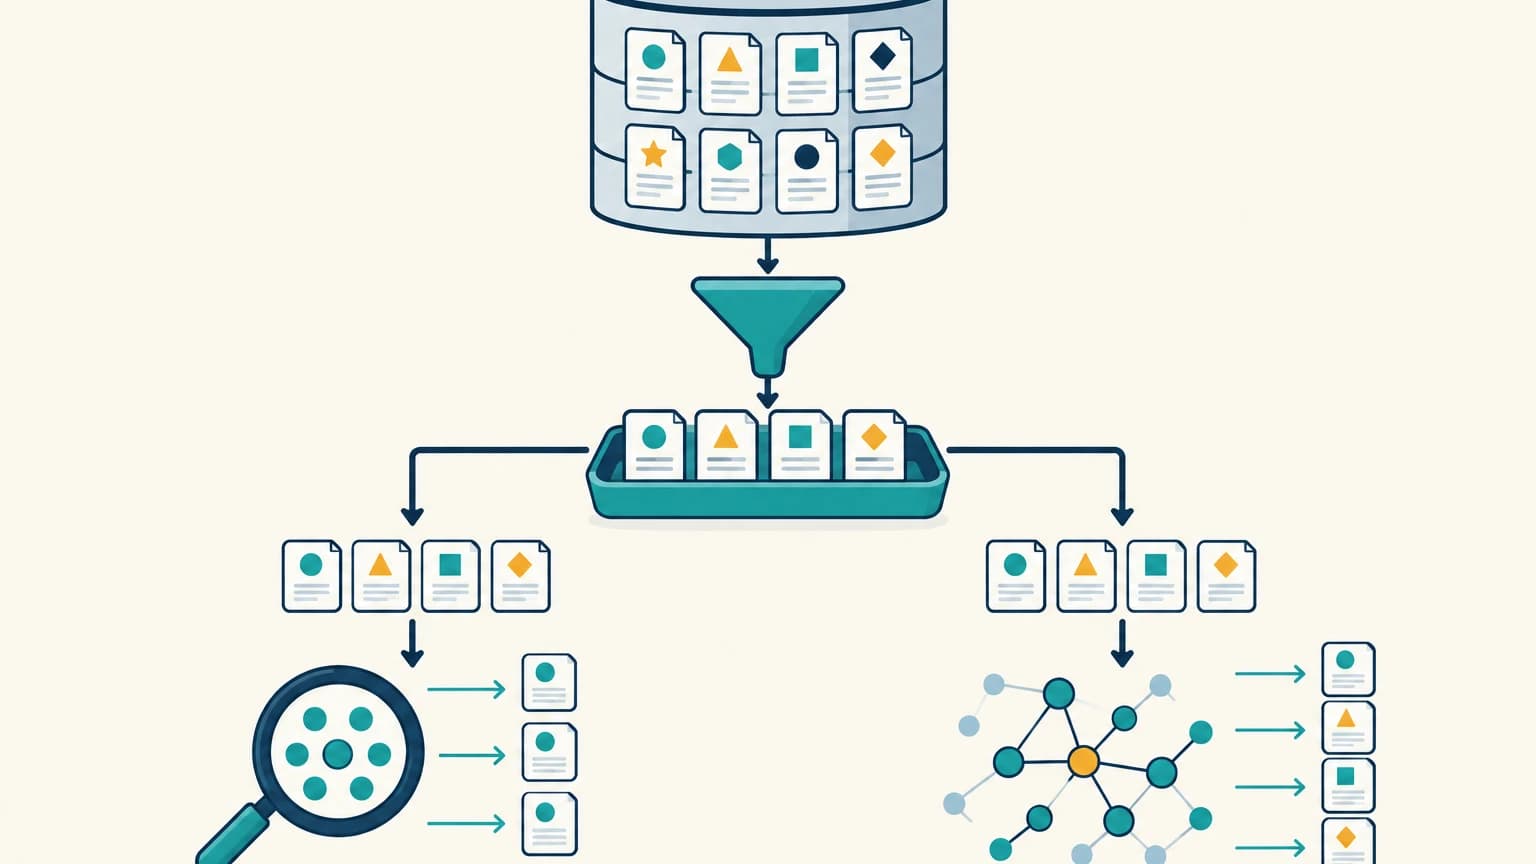
실습 저장소의 전체 문서는 241,787개입니다. 그런데 기본 벡터 검색 대상은 긴 문서 25,000개에 조건부 추가 문서를 합쳐 최대 25,002개뿐이에요. 키워드 검색에서만 나온 문서라면 애초에 임베딩이 없을 수 있다는 뜻이죠. 그러니 어떤 문서가 벡터 검색 결과에서 빠졌다고 해서 곧바로 의미 검색이 실패했다고 읽으면 곤란합니다. 결합 효과를 비교하려면 임베딩이 있는 동일한 문서 집합 안에서 보셔야 해요.
재현 환경은 PostgreSQL 17과 pg_textsearch 1.5.1을 기준으로 잡습니다. 실행 전에 pg_available_extensions에서 각 확장의 가용 버전과 설치 버전을 확인해 두세요. 여기서 흔히 헷갈리는 부분이 패키지 이름과 SQL 확장 이름이 다르다는 점인데, 아래 표로 정리해 두었습니다.
| 구성 요소 | SQL 확장 이름 | 담당 기능 |
|---|---|---|
pg_textsearch | pg_textsearch | BM25 키워드 검색 |
pgvector | vector | 벡터 유사도 검색 |
pgvectorscale | vectorscale | StreamingDiskANN 인덱스 추가 |
PostgreSQL 기본 전문 검색에 있는 ts_rank와 ts_rank_cd도 BM25와 같은 것이라고 오해하기 쉽습니다. 둘은 전체 문서 집합의 통계를 사용하는 BM25와는 다른 랭킹 방식이에요. 기본 전문 검색을 벡터 검색과 결합하는 것 자체는 가능하지만, 강좌의 BM25 구성을 그대로 재현하려면 pg_textsearch가 필요합니다.
RRF로 두 후보 목록을 합치는 방법
흐름은 단순합니다. 키워드 검색기와 벡터 검색기가 각자의 기준으로 후보를 정렬해 문서별 순위를 구하고, 같은 문서의 RRF 기여도를 더한 다음 최종 점수가 높은 결과부터 반환하면 돼요.
RRF는 원래 검색 점수를 직접 더하지 않고 Σ 가중치 / (k + 순위)를 계산합니다. 각 목록에서 순위가 높을수록 기여도가 커지고, 양쪽 목록에 모두 등장한 문서는 두 기여도를 함께 받아요. k는 상위 순위끼리 얼마나 큰 차이를 둘지 조절하는 상수이고, 가중치는 검색기별 반영 비중입니다. 점수 대신 순위를 쓰니 서로 다른 점수 척도를 맞추는 부담은 줄어듭니다. 대신 원래 점수 사이에 있던 차이는 결합 결과에 반영되지 않는다는 점을 감안하셔야 해요.
구현하다 보면 정렬 방향에서 실수가 잘 나옵니다. 단계마다 오름차순인지 내림차순인지 확인해 보세요. pg_textsearch 1.5.1 문서에 따르면 <@> 연산자는 음수 BM25 점수를 반환하므로 오름차순으로 정렬합니다. 벡터 검색의 코사인 거리 역시 작을수록 가까우니 오름차순이에요. 마지막 RRF 점수만 클수록 좋기 때문에 내림차순으로 뒤집어야 합니다.
가중치 조절은 그다음 일입니다. 먼저 후보 수가 충분한지부터 보시길 권하는데, RRF는 전달받은 목록을 합칠 뿐 후보에서 빠진 문서를 새로 찾아내지는 못하기 때문이에요. 관련 문서가 후보에 들어오는지 확인한 뒤에 반영 비중을 손보는 순서가 합리적입니다.
질의 유형과 필터별로 품질과 속도를 따로 검증하세요
평가할 때는 질의를 고유명사 질의, 개념 설명 질의, 필터 포함 질의로 나눠 보는 편을 권합니다. 질의마다 관련 문서가 후보에 포함되는지, 최종 결과에서 몇 번째쯤에 놓이는지 기록해 두세요. BM25·벡터·RRF 결과를 나란히 놓고 보면 결합이 도움이 되는 유형과 오히려 순위가 밀리는 유형이 쉽게 구별돼요.
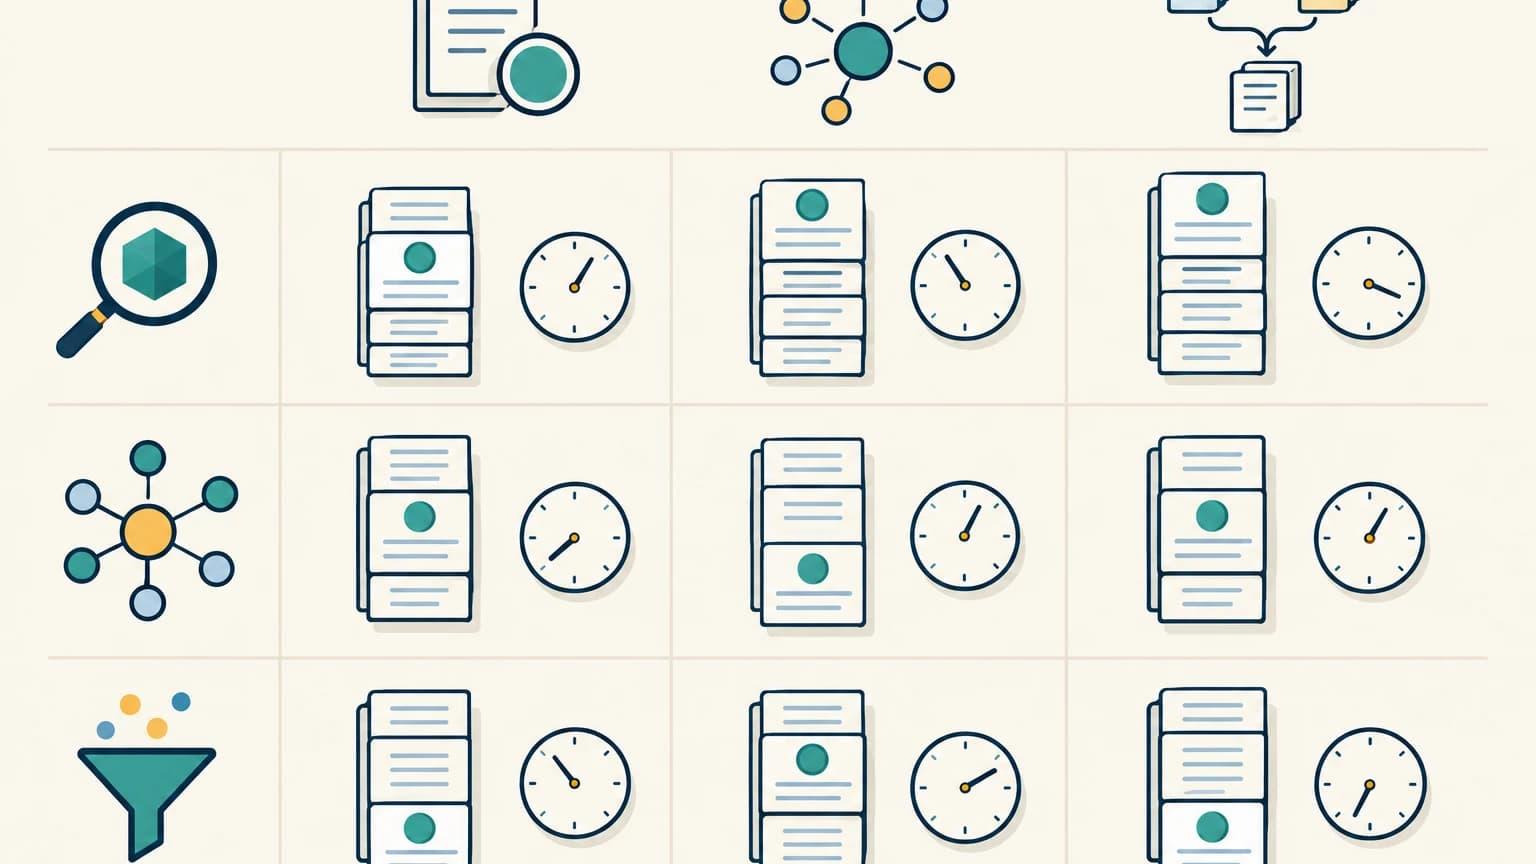
검색 품질과 실행 시간은 섞지 말고 별도로 판단해야 합니다.
실행 계획과 시간은 EXPLAIN (ANALYZE, BUFFERS)로 확인합니다. 필터를 붙였다면 반환된 문서 수도 꼭 같이 보세요. 근사 검색에서는 인덱스 탐색이 끝난 뒤 필터가 적용되기 때문에, 요청한 개수보다 적은 결과가 나올 수 있어요. 이럴 때는 pgvector 공식 문서의 반복 탐색 기능을 검토해 볼 만한데, 사용하는 인덱스와 설정에 맞는지는 문서에서 확인하셔야 합니다.
끝으로 범위를 짚어 두면, 강좌의 구현은 로컬 교육용 앱이라 운영 서비스에 쓰려면 추가 설계가 필요해요. 한국어 검색에 활용하려는 경우에도 토큰화 설정과 임베딩 모델의 품질을 한국어 질의·문서로 별도 검증해야 합니다.
자주 묻는 질문
- PostgreSQL의 ts_rank와 ts_rank_cd도 BM25인가요?
- 두 함수는 전체 문서 집합의 통계를 사용하는 BM25와 다른 랭킹 방식입니다. 강좌의 BM25 구성을 재현하려면 pg_textsearch가 필요합니다.
- 키워드 검색에서 찾은 문서가 벡터 검색에는 왜 없나요?
- 실습 저장소의 전체 문서는 241,787개지만 기본 벡터 검색 대상은 최대 25,002개여서, 해당 문서의 임베딩이 없을 수 있습니다. 먼저 두 검색기의 검색 대상 범위를 확인하세요.
- BM25와 벡터 검색, RRF의 정렬 방향은 어떻게 다른가요?
- pg_textsearch 1.5.1의 <@> 연산자가 반환하는 음수 BM25 점수와 벡터 검색의 코사인 거리는 오름차순으로 정렬합니다. 최종 RRF 점수는 클수록 좋으므로 내림차순을 사용합니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.