Qwen-Image-2.1-Turbo 로컬 실행: 8단계 생성의 설치 조건과 평가 기준
Qwen-Image-2.1-Turbo의 연구·평가용 공개 라이선스와 상업 이용 조건, 로컬 설치에 필요한 지원 기능을 정리합니다. 저장 용량과 VRAM을 구분하고 8단계 생성의 속도·품질을 같은 조건에서 비교하는 방법도 안내합니다.
Hyuk · · 4분 · AI
핵심 요약
- 공개 라이선스의 허용 범위는 연구·평가 목적이며, 상업 이용에는 별도 라이선스가 필요합니다.
- Turbo의 저장된 8단계 샘플링 일정을 읽을 수 있는 Diffusers 소스가 필요합니다.
- 저장소의 파일 용량은 최소 VRAM을 뜻하지 않으며, GPU별 실행 가능 여부와 속도는 별도로 측정해야 합니다.
- 속도와 품질은 프롬프트·해상도·캐시 등의 조건을 맞추고 여러 seed로 비교해야 합니다.
Qwen-Image-2.1-Turbo는 공개 가중치를 내려받아 로컬에서 이미지 생성과 편집을 돌릴 수 있는 8단계 체크포인트입니다. 다만 공개 라이선스가 허용하는 범위는 연구·평가 목적이에요. 8단계라는 숫자만 보고 기본 모델보다 5배 빠르다거나 저사양 GPU에서도 돌아간다고 판단하기도 어렵습니다.
확인은 이용 조건, 설치 환경, 속도·품질 측정 순서로 하기를 권합니다. 실제 제작에 쓸 권한이 있는지부터 봐 두면 설치하고 비교하는 데 드는 수고를 줄일 수 있거든요.
어디까지 쓸 수 있나: 이용 범위와 상업 라이선스
Turbo LICENSE는 비상업 목적을 연구 또는 평가로 정의하고, 사용·수정·배포 등을 그 범위 안으로 제한합니다. 상업적으로 쓰려면 별도 라이선스가 필요하고, 신청 주소는 model-business@notice.qwencloud.com이에요. 처리 기간이나 가격, 승인 기준은 따로 확인해야 합니다.
수익형 블로그 썸네일이나 고객 납품용 이미지를 만들 생각이라면 사용 목적을 구체적으로 적어 문의하세요. 이때 확인할 내용은 두 가지로 나누는 게 좋습니다. 하나는 모델을 상업 목적으로 실행할 권한이고, 다른 하나는 생성물을 게시·납품할 수 있는 범위예요. 생성물을 어디까지 쓸 수 있는지만 살피다가 모델 실행 권한 자체를 빠뜨리기 쉽기 때문입니다.
설치 전에 확인할 지원 기능과 메모리
설치는 Turbo 모델 카드의 본문 안내를 기준으로 삼습니다. 필요한 구성은 CUDA 호환 PyTorch, 최신 Diffusers 소스, transformers>=5.17.0, accelerate, pillow이고, 기본 모델의 공식 저장소에는 torch>=2.4.0도 명시돼 있어요. 페이지 상단의 일반 설치 예제가 먼저 눈에 들어오지만, 그보다 Turbo 본문의 지원 조건을 먼저 보세요.
가장 놓치기 쉬운 부분은 QwenImage21Pipeline이 모델 설정에 저장된 샘플링 일정을 읽을 수 있어야 한다는 점입니다. 샘플링 일정이란 노이즈를 걷어 내며 이미지를 만드는 단계 구성을 말해요. Turbo는 저장된 8단계 일정을 쓰기 때문에 num_inference_steps 값만 바꿔서는 이 일정을 덮어쓸 수 없습니다. 그러니 코드에서 모델 이름만 바꿔 넣기 전에, 쓰고 있는 Diffusers 소스가 이 기능을 지원하는지부터 확인하세요.
나중에 환경을 재현할 수 있도록 모델 리비전, Diffusers 커밋, 라이브러리 버전은 함께 기록해 두는 게 좋습니다.
메모리에서 흔히 헷갈리는 건 모델 규모와 파일 용량이에요. 7B는 시각 생성부의 규모이지, 텍스트 인코더까지 포함한 전체 파이프라인 크기가 아닙니다. Turbo 저장소에 표시된 용량은 약 32.5GB, 텍스트 인코더 파일은 17.5GB인데, 둘 다 저장 공간에 관한 수치라서 최소 VRAM으로 옮겨 적으면 안 됩니다.
기본 모델은 일부 처리를 CPU로 넘기는 offload 예제를 제공해요. 하지만 공식 카드만으로는 최소 VRAM이나 소비자 GPU별 성능을 정하기 어렵습니다. 특정 GPU에서 실행이 되는지, 지연 시간이 얼마나 나오는지는 따로 측정해서 확인해야 해요.
속도와 품질은 어떻게 비교할까
아래는 측정 결과가 아니라 평가 계획입니다. 비교 기준은 기본 모델 공식 예제의 40단계와 Turbo에 저장된 8단계 일정으로 잡아요. 여기서 40단계는 그 예제의 설정일 뿐이니, 모든 실행 경로의 기본값으로 읽지 않도록 주의하세요.
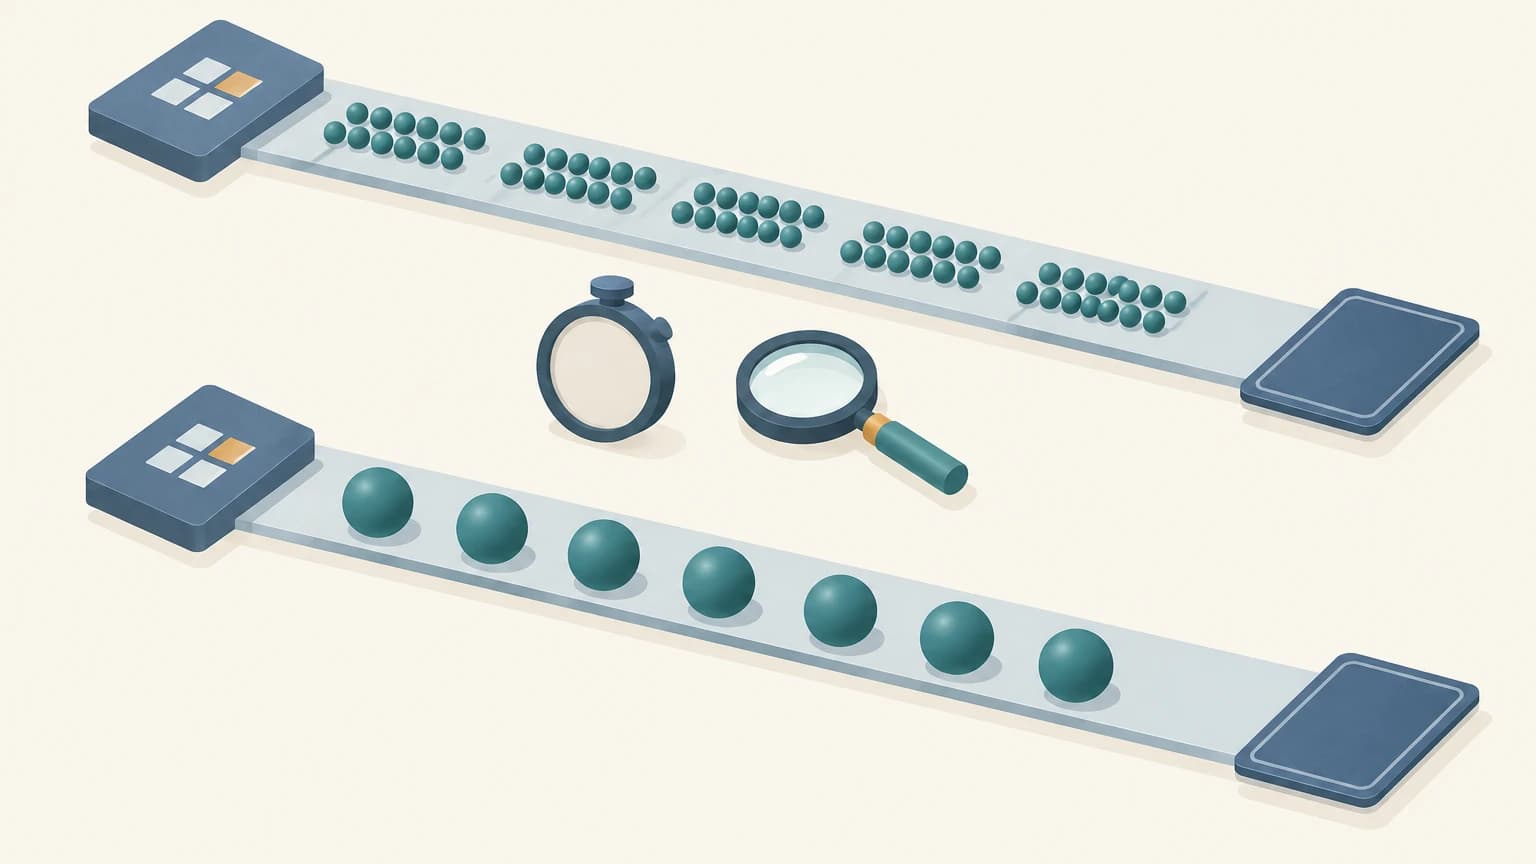
- 연구·평가 환경에서 GPU·VRAM·시스템 RAM·드라이버와 코드·모델 리비전을 기록합니다.
- 프롬프트·해상도·참조 이미지·정밀도·offload·캐시 조건을 맞추고, CFG처럼 차이가 남는 설정은 함께 공개합니다.
- 같은 seed와 난수 생성 장치를 쓰되 여러 seed로 반복해서, 한 장의 성공 결과에 평가가 치우치지 않게 해요.
- 다운로드, 모델 로딩, 첫 생성, 준비 실행 후 한 장당 지연을 나눠 측정합니다. 최대 메모리도 로딩과 추론을 구분하고, 측정 도구와 범위를 기록해 두세요.
헷갈리기 쉬운 지점은 단계 수와 전체 시간을 같은 비율로 보는 거예요. 단계 수가 줄어든 비율과 전체 작업 시간이 줄어든 비율은 다를 수 있습니다. Prefix KV cache는 단계 사이에서 텍스트와 참조 이미지의 문맥 계산을 재사용하므로, 캐시 조건도 비교 기록에 포함해야 합니다.
품질은 작업마다 기준을 따로 정해 두고 보세요. 한글이라면 지정한 문구의 철자, 띄어쓰기, 줄바꿈을 확인합니다. 투명 이미지는 저장된 PNG의 실제 알파 값을 살피고, 서로 다른 배경색 위에 올렸을 때 가장자리가 어떻게 보이는지도 봐야 하고요. 편집 작업에서는 요청한 변경 영역과 그대로 유지돼야 할 영역을 따로 평가합니다. 다중 참조를 쓴다면 인물이나 제품의 속성이 서로 섞이지 않는지도 확인해야 해요.
GPU별 속도, 최소 VRAM, 기본 모델과의 품질 동등성은 실측하기 전까지 미확인으로 남겨 두세요. sigmas를 직접 지정하면 일정을 바꿀 수는 있지만, 사용자 지정 일정은 해당 체크포인트에서 평가되지 않았다는 점도 함께 고려해야 합니다.
자주 묻는 질문
- Qwen-Image-2.1-Turbo로 수익형 블로그 썸네일을 만들어도 되나요?
- 상업 이용에는 별도 라이선스가 필요합니다. `model-business@notice.qwencloud.com`으로 사용 목적을 적어 문의하고, 모델 실행 권한과 생성물 게시 범위를 나눠 확인하세요.
- 8단계면 기본 모델의 40단계보다 5배 빠른가요?
- 단계 수가 줄어든 비율과 전체 작업 시간이 줄어든 비율은 다를 수 있습니다. 40단계는 기본 모델 공식 예제의 설정이며, 실제 속도는 같은 조건에서 측정해야 합니다.
- `num_inference_steps`를 바꾸면 Turbo의 생성 단계도 바뀌나요?
- Turbo에 저장된 8단계 일정은 `num_inference_steps` 값만으로 덮어쓸 수 없습니다. `sigmas`를 직접 지정하면 변경할 수 있지만, 사용자 지정 일정은 해당 체크포인트에서 평가되지 않았습니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.