Talorys Cloudflare AI 비서: 내 계정 배포 구조와 운영 부담 이해하기
Talorys Cloudflare AI 비서는 사용자 Cloudflare 계정에 배포하는 개인용 AI 비서입니다. 요청 경로와 인증 구조, 설치 후 점검 절차, 무료 한도와 백업 복원 범위를 살펴봅니다.
Hyuk · · 4분 · AI
핵심 요약
- Talorys는 사용자 Cloudflare 계정에서 실행되며 업데이트·비용 확인·백업은 사용자가 관리해야 합니다.
- 기본 배포에서 백엔드 공개 URL을 꺼도 Pages는 인터넷에서 접근할 수 있으며, 데이터 접근은 서버 인증이 통제합니다.
- 운영 전에는 AI 추론과 실행·저장 사용량을 나누어 살피고, 백업에서 복원되지 않는 설정과 자동화 상태를 확인해야 합니다.
Talorys Cloudflare AI 비서는 개발사 서버가 아니라 내 Cloudflare 계정에 직접 배포해서 쓰는 개인용 AI 비서입니다. 저장과 실행, AI 추론은 Cloudflare가 맡고 업데이트·비용 확인·백업은 사용자 몫으로 남아요.
그래서 기능이 몇 개인지보다 운영 책임이 어디까지인지를 먼저 보는 편이 좋습니다.
공식 README는 채팅·기억·할 일·노트·프로젝트와 일회성·반복 알림을 안내하고 있어요. 여러 기기에서 접속해도 같은 소유자 하나로 쓰는 구조입니다. 기능 목록이 마음에 든다면 다음으로는 배포 이후의 관리까지 내가 감당할 수 있는지를 함께 따져 보세요.
요청은 어디로 흐르고, 인증은 어디서 막을까
기본 CLI 배포 경로는 '공개 Pages → 비공개 Worker → Agents SDK 기반 Durable Object·SQLite' 순서로 이어집니다. 브라우저가 보낸 /api/* 요청을 Pages Function이 받아서 서비스 바인딩으로 Worker에 넘기는 식이에요. 서비스 바인딩은 공개 인터넷 주소를 거치지 않고 Cloudflare 내부 연결로 서비스를 호출하는 방식을 말합니다.
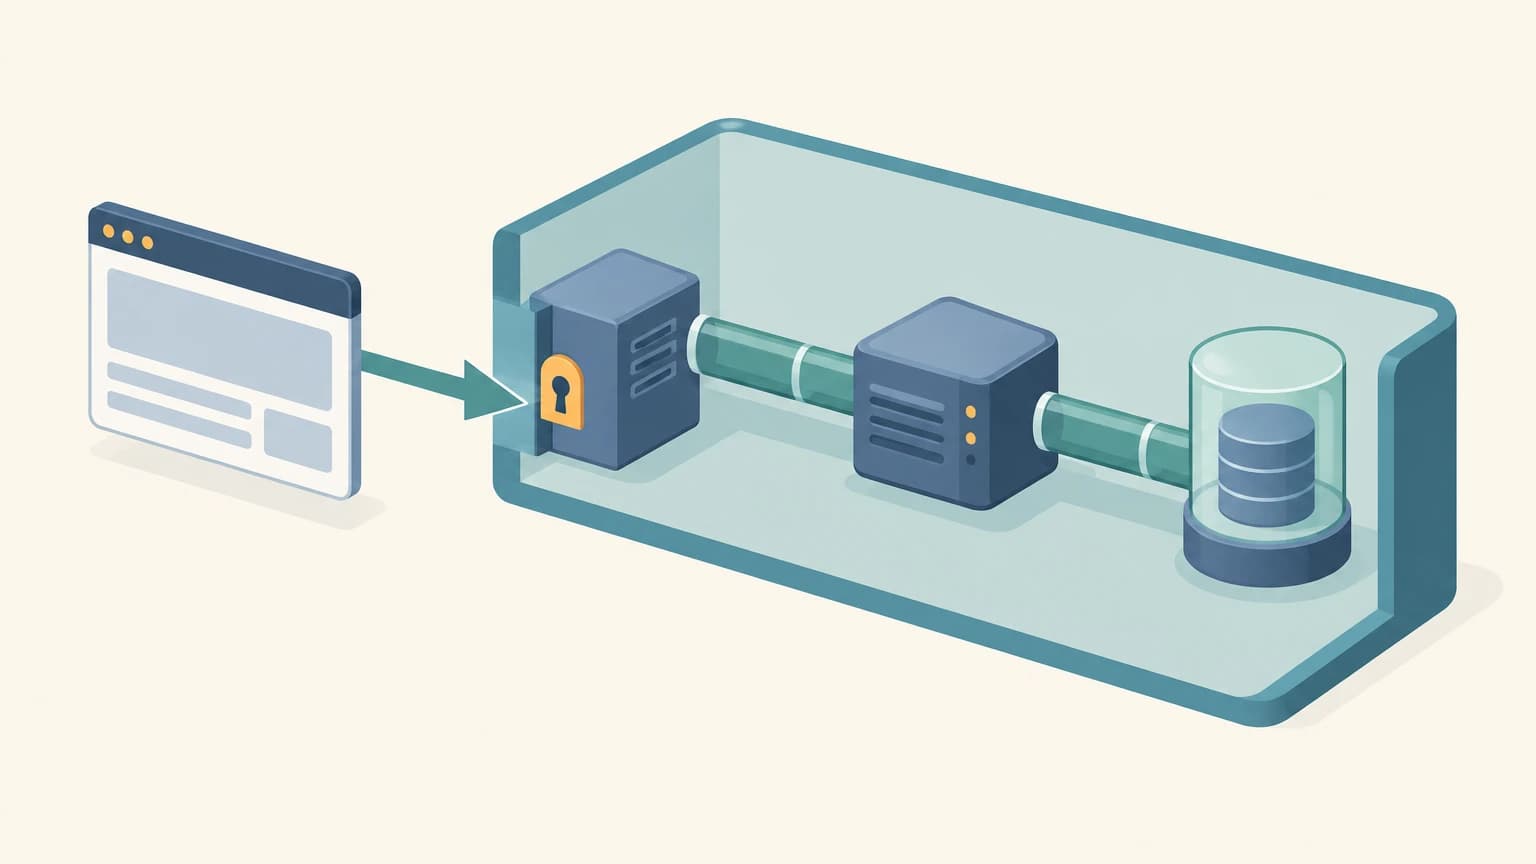
Worker는 요청을 서버에서 고정해 둔 personal-agent 객체로 보냅니다. SQLite 데이터와 API 로직, 예약 실행이 모두 이 객체에서 처리돼요. AI 답변을 만들 때는 관련 기억·대화 요약·최근 기록으로 문맥을 꾸려 Workers AI에 전달합니다. 상태와 예약 작업을 한 객체에 모아 둔 구조는 실행 주체끼리 맞춰야 할 동기화 지점을 줄이려는 설계로 볼 수 있어요.
여기서 많이 헷갈리는 부분은 백엔드 주소의 공개 여부와 사용자 인증이 서로 다른 문제라는 점입니다. 기본 배포는 workers_dev: false, preview_urls: false로 백엔드 공개 URL을 꺼 둡니다. 하지만 Pages는 인터넷에서 접근할 수 있으므로 데이터 접근을 실제로 통제하는 건 서버 인증이에요. 별도로 안내하는 단일 Worker 배포는 공개 workers.dev 주소를 쓰니까, 내가 어느 방식으로 배포했는지부터 구분해 두세요.
설치한 뒤 무엇부터 확인할까
설치하려면 Node.js 22 이상이 필요합니다. 아래 명령 하나로 Cloudflare 인증, 계정 선택, 소유자 암호 설정, 리소스 배포와 상태 확인까지 진행돼요.
npx create-talorys@latest배포가 끝나면 예약 실행은 Cloudflare가 담당하므로 개인 컴퓨터를 계속 켜 둘 필요는 없습니다.
설치 직후 화면이 뜨는 것만 보고 끝내기엔 아직 이릅니다. 아래 순서로 확인해 보세요. 인증 확인을 맨 앞에 둔 이유는 앞에서 말했듯 Pages가 공개돼 있기 때문이에요.
- 비로그인 상태에서 데이터 접근이 차단되는지 확인합니다.
- 할 일을 생성·수정하고 저장한 기억을 대화에서 다시 불러오는지 살펴봅니다.
- 일회성·반복 알림의 도착 여부와 지연을 기록합니다.
나중에 같은 상태를 재현할 수 있도록 설치한 패키지 버전과 참조한 저장소 커밋도 남겨 두세요. 저장소 main 문서와 npm의 @latest가 같은 구현인지는 따로 확인해야 합니다.
비용은 어디서 나가고, 백업은 어디까지 돌아올까
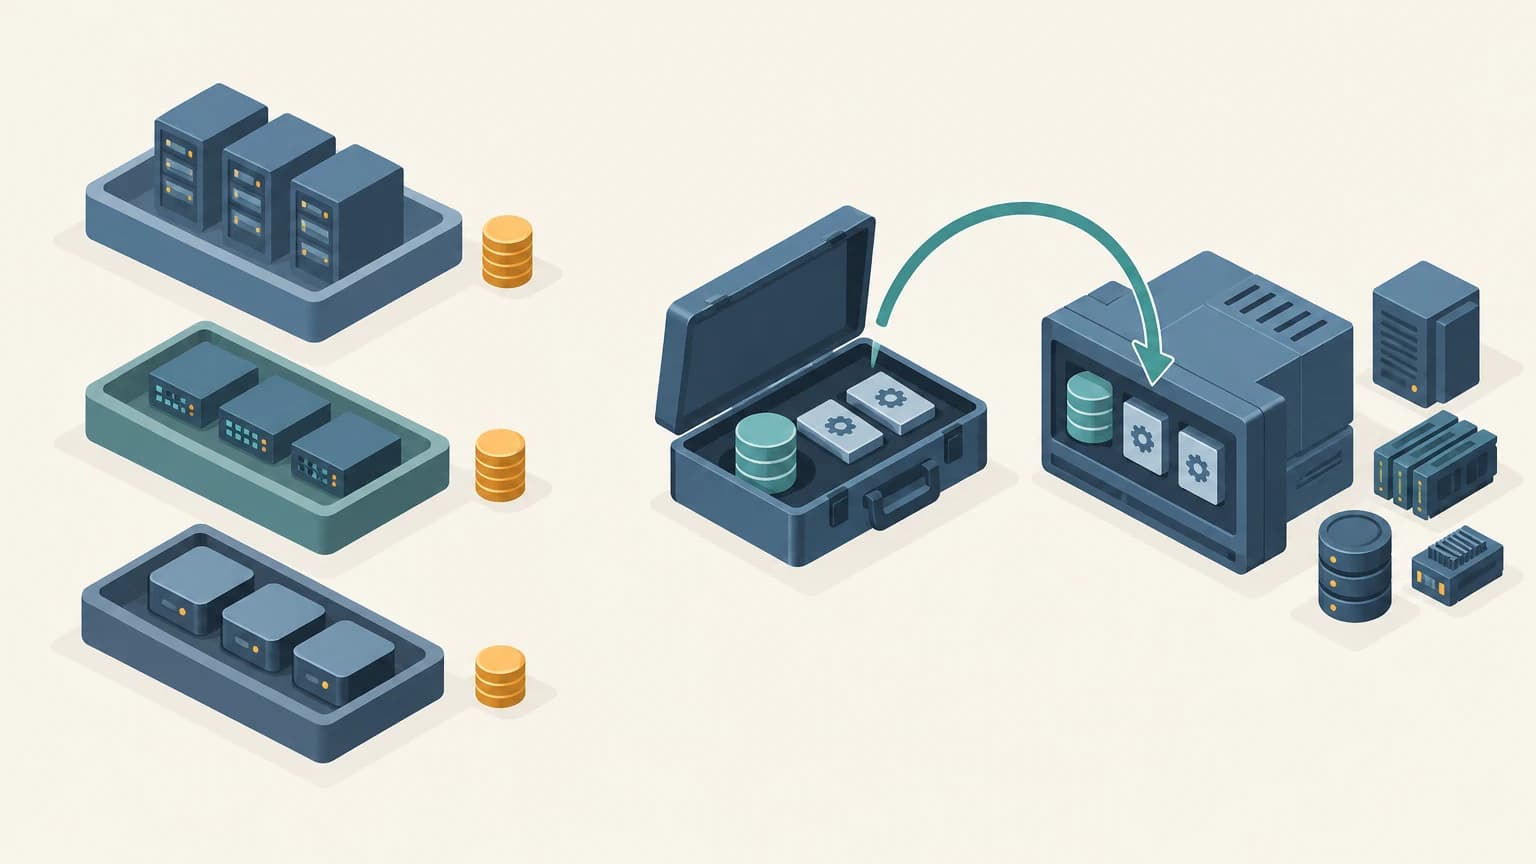
MIT 라이선스가 정하는 건 소스의 이용·수정·배포 조건이에요. Cloudflare 이용료는 이와 별개로 발생합니다. 운영비는 세 층으로 나눠 보면 정리가 쉬워요.
| 비용 층 | 주요 무료 범위 | 확인할 항목 |
|---|---|---|
| Workers·Pages Functions | 일 10만 요청, 호출당 CPU 10ms | 요청 수·CPU 사용량 |
| Durable Objects 실행·저장 | 일 10만 요청·13,000GB-s, SQLite 일 500만 행 읽기·10만 행 쓰기, 총 5GB 저장 | 객체 실행량·읽기·쓰기·저장량 |
| Workers AI | 일 10,000 Neurons | 모델별 추론 사용량 |
이 무료 할당량을 Talorys 전용 한도로 읽으면 곤란합니다. Workers 유료 플랜은 계정당 월 최소 $5이고, 유료 플랜에서 Workers AI 일 무료분을 넘기면 1,000 Neurons당 $0.011이 적용돼요. Neurons는 GPU 연산량을 나타내는 단위라서 대화 몇 번에 해당하는지 고정된 숫자로 환산하기 어렵습니다. 추론 비용은 Workers AI 요금 문서부터 확인하세요.
어느 한도가 먼저 바닥나느냐에 따라 증상도 달라집니다. AI 한도만 소진했다면 할 일 같은 비AI 기능은 계속 동작할 수 있어요. Workers나 Durable Objects의 실행·저장 한도까지 소진하면 그런 작업도 실패할 수 있습니다. 두 사용량을 따로 지켜봐야 하는 이유가 여기에 있어요.
백업은 JSON 파일이 있는지보다 무엇이 복원되는지를 먼저 보세요. 내보내기에서는 세션과 자격 증명이 빠지고, 가져오기에서는 모델·한도 같은 일부 설정이 복원되지 않습니다. 새 자동화도 일시 정지 상태로 들어와요. 새 환경에 가져온 뒤에는 데이터와 설정을 원래 것과 대조하고 자동화 상태까지 확인해야 합니다.
개발사 서버에 개인 데이터를 두지 않는다고 해서 데이터를 맡기는 곳이 없어지지는 않습니다. 저장·실행·추론은 여전히 Cloudflare가 담당해요. Workers AI 데이터 정책은 명시적 동의 없이 고객 콘텐츠를 모델 학습이나 서비스 개선에 쓰지 않는다고 설명합니다. 다만 이 설명만으로는 구체적인 처리 국가나 추론 데이터 보존 기간까지 확정하기 어려워요.
위 내용은 2026-10-15 문서 기준입니다. 실제 배포 동작과 보안 통제, 백업 복원 결과는 각자의 운영 환경에서 따로 검증해야 해요.
자주 묻는 질문
- 알림을 받으려면 개인 컴퓨터를 계속 켜 둬야 하나요?
- 배포 후 예약 실행은 Cloudflare가 담당하므로 개인 컴퓨터를 계속 켜 둘 필요는 없습니다.
- AI 무료 한도를 소진하면 할 일 기능도 멈추나요?
- AI 한도만 소진하면 할 일 같은 비AI 기능은 유지될 수 있습니다. 다만 Workers나 Durable Objects의 실행·저장 한도까지 소진하면 해당 작업도 실패할 수 있습니다.
- JSON 백업을 가져오면 설정과 자동화도 모두 복원되나요?
- 모델·한도 등 일부 설정은 복원되지 않으며, 새 자동화는 일시 정지 상태로 들어옵니다. 세션과 자격 증명도 내보내기에서 제외됩니다.
출처
관련 글
댓글
Giscus를 연결하면 댓글이 열립니다.